LLM이 출시 초보다 못해졌다는 느낌이 들 때, 그걸 감이 아니라 데이터로 확인하는 방법을 정리한다. 고정 문항 패널을 매일 같은 조건으로 돌려 분포를 비교하는 측정 프로토콜, 출력 토큰 같은 조기 신호, 너프 의심의 실제 원인이 되었던 사례까지 2026년 10월 기준 공식 자료와 검증된 실험로 짚는다.
핵심 요약
- “너프” 의심의 대부분은 재현 가능한 측정 없이는 참도 거짓도 아니며, n=1 비교는 판정 근거가 되지 않는다.
- 측정이 통제되지 않으면 안 된다: 고정 프롬프트, 고정 채점, 핀된 CLI, 매일 같은 시각, 그리고 통계적 유의성.
- 실제로 있었던 품질 저하 사례는 “은밀한 너프”가 아니라 클라이언트 기본값 변경, 세션 버그, 시스템 프롬프트 수정이었다 — Anthropic이 2026년 4월 postmortem으로 공식 인정했다.
- 검증된 실험(livenerf)에 따르면 모델이 “덜 생각”하게 되면 정확도보다 출력 토큰이 먼저 움직인다. 개인 추적에서 토큰 수 추적이 가장 저렴한 조기 경보다.
- 같은 계열 모델 교체(예: Opus 5 ↔ 5.5) 정도의 미세한 차이는 월 몇 달러짜리 개인 추적으로는 잡지 못한다. 한계를 알고 측정하자.
왜 “네프 느낌”만으로는 판정이 안 되는가
LLM은 본질적으로 비결정적(non-deterministic)이다. 같은 프롬프트를 두 번 보내도 출력이 달라진다. sampling 온도를 0으로 고정해도 완전한 재현이 보장되지 않고, 최신 모델은 thinking을 끌 수 없는 경우도 있다. 그래서 “어제는 잘하던 게 오늘은 안 된다”는 경험 하나로는 다음 세 가지가 구분되지 않는다.
- 정상적인 샘플링 변동
- 실제 서비스 변경(라우팅, 기본값, 프롬프트, 인프라)
- 사용자 쪽 변화(프롬프트·컨텍스트가 길어짐, 과제가 어려워짐, 신선함 효과가 사라짐)
HN에서 이 주제를 다룰 때마다 반복되는 정론도 같다. “네트워크 느낌”은 증거가 아니고, n=1 비교는 쓸모가 없다는 것. 실제로 한 커뮤니티에서는 여러 해 동안 “너프됐다”는 보고가 반복됐지만 지속적으로 재현된 사례는 소수였고, 그 소수는 뒤에서 설명할 “인시던트”로 판명됐다.
측정 프로토콜: 고정 패널 + 매일 실행 + 통계
2026년 9월 Opus 5.5 출시 직후 시작된 오픈소스 실험 livenerf가 좋은 참고 사례다. 이 프로젝트는 “출시 후 모델이 조용히 나빠지는가”라는 질문 하나에 대해, 논쟁이 감싸움이 되지 않도록 통제된 측정 설계를 공개하고 실행 중이다. 핵심 설계는 다음과 같다.
| 설계 요소 | livenerf의 선택 | 이유 |
|---|---|---|
| 문항 선정 | GPQA·MMLU-Pro·경시수학 등 2,336문항 스크리닝 후 “가끔 맞히는” 78문항만 패널로 고정 | 항상 맞거나 항상 틀리는 문항은 변화를 감지 못 함 |
| 실행 조건 | 프롬프트 동결, CLI 버전 핀(2.1.280), 하루 1회 전 패널 90샘플 | 도구가 바뀌면 모델이 바뀐 것처럼 보임 |
| 판정 방식 | 사전등록 프로토콜 + 기준일 대비 paired 점수 차이, 군집 표준오차 | 사후 해석·체리피킹 차단 |
| 통계 기반 | Anthropic 자체 방법론 문서(“Adding Error Bars to Evals”) 따름 | 홈브류 통계 논쟁 방지 |
| 탐지력 | 10일 윈도 기준 약 ±7.5포인트 정확도 변화 감지 | 월 구독료의 약 3.6% 비용 |
여기서 개인이 가져갈 수 있는 원칙은 명확하다. 바꿀 수 있는 것은 전부 동결하고, 바뀐 것만 측정한다. 프롬프트·채점 기준·도구 버전·실행 시각이 흔들리면 그 흔들림이 모델 변화로 위장한다.
조기 신호는 토큰 수다
livenerf가 검증 단계에서 얻은 가장 실용적인 발견은 이것이다. 노력(effort) 등급을 high에서 medium으로 낮추면 정확도는 −4.2 ± 3.9포인트로 통계적으로 애매하지만, 출력 토큰은 −26%로 즉각·명확하게 줄어든다. low까지 내리면 정확도 −8.3 ± 4.5포인트, 토큰 −62%다.
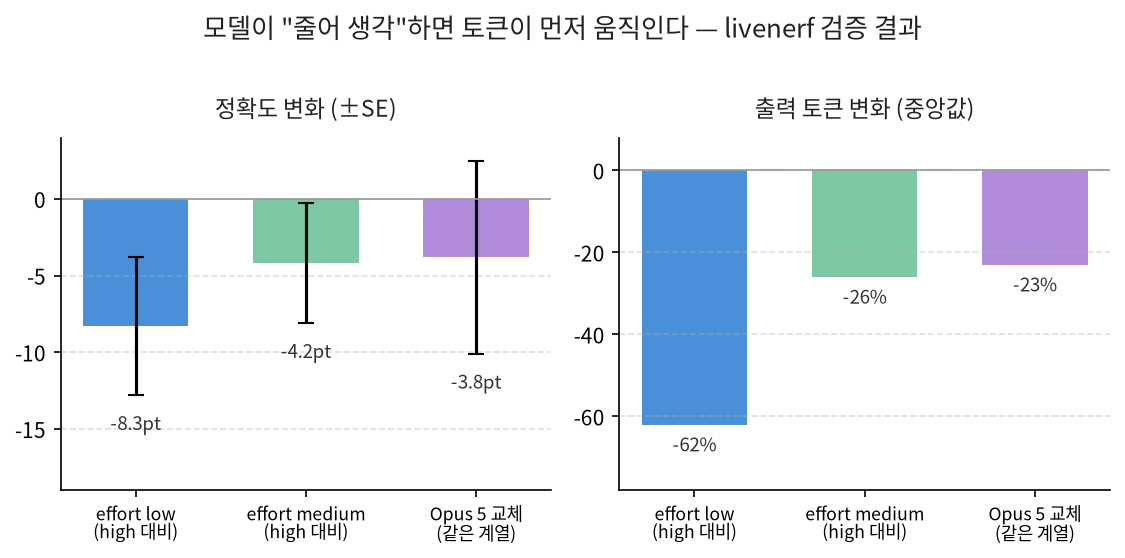 alt=”livenerf 검증 결과: 노력 등급 변경과 모델 교체가 정확도와 출력 토큰에 미치는 영향”/>
*출처: ninjahawk/livenerf 저장소 검증 수치 (2026-10-01 기준)*
즉 개인 수준에서 “모델이 예전보다 덜 생각하는 것 같다”를 확인하는 가장 싼 방법은 정답률 재측정이 아니라 동일 과제의 출력 토큰 중앙값 추적이다. 토큰 수는 로그에 남고, 노이즈가 적고, 변화가 정확도보다 먼저 나타난다.
주의할 점도 있다. livenerf의 검증에서 Opus 5로 모델을 통째로 바꿔도 Opus 5.5와 99% 신뢰수준에서 구분되지 않았다(−3.8 ± 6.3포인트). 같은 계열의 미세한 교체는 이 정도 규모의 추적으로는 잡을 수 없다는 것을 스스로 측정한 셈이다. 개인 추적의 한계를 인정하고, “잡을 수 있는 것”(노력 등급·프롬프트 변경급의 변화)과 “못 잡는 것”(동급 모델 스왑)을 구분해서 해석해야 한다.
실제로 있었던 “너프”의 정체 — Anthropic postmortem
“은밀한 너프”가 사실이었던 적이 있을까. Anthropic은 2026년 4월, Claude Code 품질 저하 보고에 대해 공식 postmortem을 발표했다. 사용자들이 “모델이 나빠졌다”고 느낀 기간의 원인을 조사한 결과, 세 가지 개별 변경이 확인됐다.
| 시점 | 변경 | 영향 | 복구 |
|---|---|---|---|
| 3월 4일 | Claude Code 기본 reasoning effort를 high → medium으로 변경 (지연 감소 목적) | Sonnet 4.6·Opus 4.6 응답 품질 저하 | 4월 7일 롤백 |
| 3월 26일 | 1시간 유휴 세션의 이전 thinking 정리 코드에 버그 → 매 턴 반복 삭제 | “건망증”처럼 보이는 품질 저하 | 4월 10일 수정 |
| 4월 16일 | 장황함 줄이기 시스템 프롬프트 추가 | 코딩 품질 저하 | 4월 20일 롤백 |
이 사례가 시사하는 바가 두 가지 있다. 첫째, 사용자들의 체감 저하는 실재했고 원인도 실재했다. 둘째, 그 원인은 “가중치를 몰래 양자화했다”류의 음모가 아니라 클라이언트 기본값·프롬프트·세션 처리의 변경이었다. API는 영향을 받지 않았고, 문제는 Claude Code·Agent SDK·Cowork 쪽이었다. Anthropic은 같은 글에서 “모델을 의도적으로 저하시킨 적은 없다”고 밝히며, 내부 eval이 초기에 재현하지 못한 이유(트래픽 슬라이스별로 다른 시점에 다른 변경이 적용됨)도 설명했다.
5단계 실전 체크리스트
내가 쓰는 모델이 나빠졌는지 의심될 때, 다음 순서로 확인한다. 하루 10분 이내로 끝나는 것부터.
- 내 쪽 변경 배제 — 시스템 프롬프트, 컨텍스트 길이, 도구 목록, 노력(effort) 설정, CLI/SDK 버전이 바뀌지 않았는지 먼저 확인한다. Opus 5.5는 API 기본 effort가 medium이므로 명시 안 하면 high가 아니다.
- 고정 과제 3~5개 재실행 — 예전에 잘 풀었던 실무 과제를 프롬프트째 저장해뒀다가 그대로 돌린다. 한 번이 아니라 3회 이상.
- 출력 토큰 중앙값 비교 — 같은 과제의 출력 토큰 수가 기록 대비 20% 이상 줄었으면 노력·프롬프트·라우팅 변경 의심. 정답률보다 민감한 지표다.
- API와 구독 경로 분리 테스트 — 같은 모델을 API로 호출해 결과가 다르면 문제는 서빙 경로(구독 클라이언트) 쪽. postmortem 사례가 정확히 이 패턴이었다.
- 공식 상태 페이지·changelog 확인 — 클라이언트 변경 이력을 먼저 본다. 모델 가중치 의심은 최후에.
자주 묻는 질문
너프 측정에는 얼마나 많은 샘플이 필요한가?
livenerf 기준으로 하루 1회 전 패널(90샘플)을 10일간 돌려야 약 ±7.5포인트 변화를 감지한다. 개인이 몇 번 물어보고 “더 멍청해졌다”고 결론 내리는 것은 이 감도에서 수십 배 모자란다. 반드시 분포 비교로 판정한다. 평가 세트 설계 자체의 원칙은 AI Evals 실무 가이드를 참고한다.
temperature 0으로 하면 재현되지 않나?
완전하지 않다. 서버 측 배치·라우팅·캐싱 상태에 따라 미세하게 달라질 수 있고, 최신 모델은 thinking을 비활성화할 수 없어 변동성이 남는다. 그래서 “완전한 결정성”이 아니라 “결정적인 것은 전부 동결”이 현실적인 목표다.
벤치마크 점수가 그대로면 너프가 아닌가?
그렇다고 단정할 수 없다. 공개 벤치마크는 운영사가 식별해 특별 취급할 수 있고(livenerf도 이 한계를 명시한다), 실사용 품질과 벤치마크 점수가 항상 일치하지 않는다. 반대로 벤치마크가 나빠졌다고 반드시 의도적 너프인 것도 아니다. 인시던트인지 의도인지는 운영사 투명성 없이는 구분 불가능하다.
그냥 다운그레이드 모델이 섞여 들어오는 건 아닐까?
같은 이름 뒤에 여러 버전이 롤아웃되는 것은 업계에서 실제로 있는 운영 방식이다. 다만 livenerf 검증에서 보았듯 동급 모델 스왑은 개인 규모 측정으로 잡기 어렵다. 의심되면 API 직접 호출과 구독 경로를 비교하는 편이 실용적이다.
정리
“모델이 나빠졌다”는 느낌은 무시할 신호도 아니지만 그 자체로 결론도 아니다. 실제 품질 저하 사례는 존재했고, 그 원인은 측정 가능한 변경이었다. 개인이 할 수 있는 가성비 최고의 대응은 (1) 고정 과제와 프롬프트 동결, (2) 출력 토큰 중앙값 추적, (3) API/구독 경로 분리 비교다. 그리고 커뮤니티 주장은 어디까지나 발견의 단서로 쓰고, 판정은 재현 가능한 측정과 공식 자료로 한다.
참고자료
- ninjahawk/livenerf — Opus 5.5 출시일 기준 30일 너프 추적 벤치마크 (GitHub)
- An update on recent Claude Code quality reports — Anthropic Engineering, 2026-04-23
- Adding Error Bars to Evals — Anthropic, arXiv:2411.00640
- Claude Opus 5.5 문서 — 기본 effort medium, 컨텍스트 1M, $4/$20 (Anthropic Platform Docs, 2026-10-02 확인)
- Opus 5.5 nerfing 논의 — r/ClaudeAI 커뮤니티 스레드 (2026-10-01~02), Hacker News “Livenerf: Has Opus 5.5 been nerfed yet?” (914 포인트)