코딩 에이전트(Claude Code, Codex, Gemini CLI)가 작성한 코드를 그대로 머지하다 보면 “고쳤다”는 말과 실제 동작이 어긋나는 변경이 배포에 섞인다. 핵심은 도구를 더 붙이는 게 아니라, 에이전트의 산출물을 사람이 검수할 수 있는 단위로 쪼개고, 자동 검토를 1차 게이트로 세운 뒤, 머지 승인은 이름 있는 사람 서명으로 남기는 것이다. 이 글은 그 3단계 게이트와 데이터 경계에 따른 도구 선택, 2026년 10월 기준 비용을 정리한다.
핵심 요약
- 결론: AI 코드 리뷰 도구는 “리뷰어 대체”가 아니라 1차 필터다. 머지 책임자는 사람이어야 한다.
- 3단계 게이트: ① 작업 단위 커밋 분할 → ② 자동 리뷰(Copilot Code Review·PR-Agent·CodeRabbit 등) → ③ 사람 승인 + 브랜치 보호 규칙 강제.
- 데이터 경계가 첫 기준: 사내 코드가 외부 SaaS·외부 모델로 나가는지부터 확인한다. 코드가 나가면 안 되는 곳은 PR-Agent 셀프호스팅(오픈소스, 모델 직접 지정) 또는 “로컬 에이전트 + 사람 리뷰” 조합.
- 비용(2026-10-05 공식 페이지 기준): GitHub Copilot Code Review는 Copilot 유료 플랜에 포함(Pro $10/월, Business $19/석/월). CodeRabbit Essentials $24/개발자/월(연간 결제), Greptile Pro $30/석/월. Claude/Codex 구독자는 추가 비용 없이 기존 에이전트로 사전 검토 가능.
- 이 글의 워크플로는 공식 문서 기반 정리이며, 특정 팀 사례를 재현한 실측이 아니다.
왜 지금 문제가 되나
에이전트로 코딩하는 팀이 늘면서 커뮤니티에서 같은 고민이 반복된다. “에이전트 커밋이 너무 커서 실제로 리뷰할 수가 없다”, “회사에 개발자가 나 혼자인데 AI가 유일한 리뷰어다”, “고쳤다고 말했는데 코드만 바뀌고 버그는 그대로다” 같은 질문이 국내외(HN, Reddit, OKKY)에서 2026년 9~10월 연이어 올라온다. 공통 원인은 둘이다. 앞서 정리한 모델 품질 저하 의심을 측정하는 방법과 마찬가지로, 결국 “믿을 수 있는 검증 지점”을 확보하는 문제다.
- 변경 단위가 사람 검수 용량보다 크다. 에이전트는 한 번에 수십 파일을 고치지만, 사람이 한 번에 검증할 수 있는 diff는 기능 단위가 원칙이다.
- “리뷰했다”와 “확인했다”가 구분되지 않는다. AI가 남긴 “LGTM”성 코멘트는 근거가 없다. 머지 승인은 변경을 저장소와 테스트로 다시 확인한 사람의 서명이어야 한다.
3단계 게이트: 분할 → 자동 검토 → 사람 승인
1단계 — 커밋을 작업 단위로 분할한다
에이전트에 처음부터 “작은 단위로 커밋을 나눠라”고 지시하는 게 원칙이고, 이미 몰아서 쓴 커밋은 git add -p로 나누거나 기능 단위로 PR을 다시 만든다. Claude Code는 공식 문서도 “생성된 PR을 제출 전에 검토하고 잠재 위험을 짚어보라”고 안내한다. 분할 기준은 코드 줄 수가 아니라 되돌리기 어려운 정도다.
- 문구·오타·테스트 이름: 자동 통과 또는 빠른 확인
- 단순 버그 수정: 1인 검토
- 기능 설계·공통 모듈·리팩터링: 관점이 다른 복수 검토
- 인증·권한·스키마 변경·외부 연동: 강화 리뷰 + 사람 승인 필수
변경이 커질수록 사람의 검증 능력이 급격히 떨어지는 건 정해진 사실이라, 아래 도식은 그 관계를 개념적으로만 표현한 것이다(실측 데이터가 아니다).
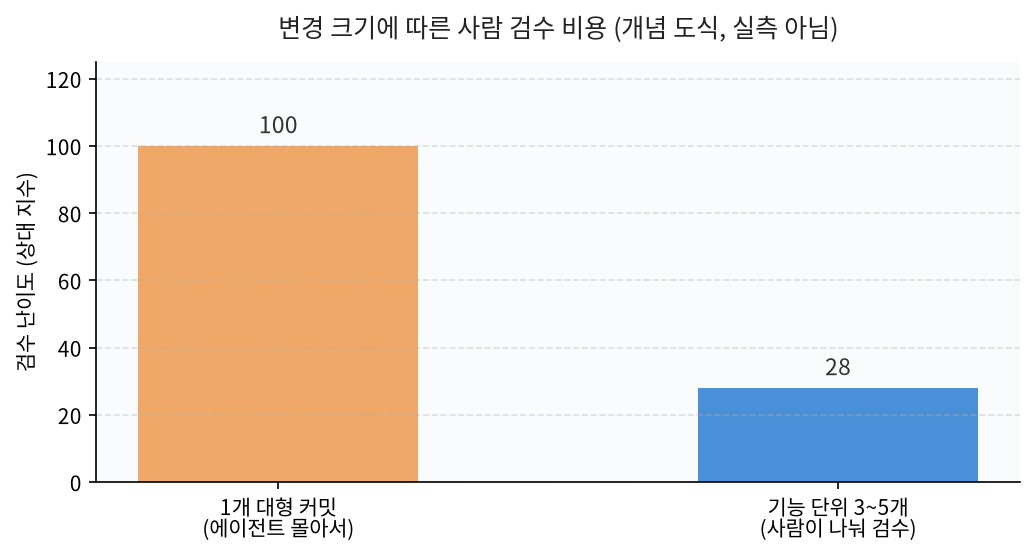
출처: 본문 개념 도식 (실측 아님)
2단계 — 자동 리뷰를 1차 게이트로 놓는다
여기서부터가 도구 선택이다. 목적은 리뷰어 대체가 아니라 사람이 봐야 할 지점을 좁히는 필터다.
| 도구 | 형태 | 시작 가격 (2026-10-05 기준) | 데이터 경계 | 알아둘 점 |
|---|---|---|---|---|
| GitHub Copilot Code Review | GitHub 내장 | Copilot Pro $10/월, Business $19/석/월에 포함 | GitHub 생태계 내 | 설치 부담 최소. GitLab·Bitbucket 미지원, 리뷰 깊이는 전문 도구보다 얕다는 평가 |
| PR-Agent (오픈소스) | CLI·GitHub Actions·Docker 셀프호스팅 | 무료 (모델 API 비용 별도) | 모델 직접 지정 가능 — OpenAI·Anthropic·Gemini·Ollama 등 LiteLLM 연동 | 코드가 외부 SaaS로 나가지 않게 직접 운영 가능. 운영 공수는 본인 부담 |
| CodeRabbit | SaaS | Essentials $24/개발자/월(연간 결제) | 코드 리뷰 목적으로 OpenAI·Anthropic에 전달되며, 공식 FAQ에 따르면 코드는 모델 학습에 쓰이지 않고 리뷰 후 저장하지 않음(SOC 2 Type II) | 리뷰 깊이 평가가 높고 설정 파일로 규칙 커스터마이징 가능. 도입 초기 노이즈 코멘트 조정 필요 |
| Greptile | SaaS | Free(개인), Pro $30/석/월 | SaaS 처리 | 저장소 전체 맥락을 읽는 리뷰. 초과 크레딧 과금 방식 |
| Claude Code / Codex 사전 검토 | 구독 에이전트 CLI | Claude Pro $17/월(연간)~·Max $100~/월, Codex Plus $20/월 | 구독 계정 경계 | PR을 열기 전 로컬에서 “내 변경을 리뷰하고 위험을 짚어라”로 검토. 푸시 전 단계라 코드 반경을 스스로 통제 |
가격은 모두 공식 페이지에 오늘(2026-10-05) 접속해 확인한 값이며 세전 미국 달러, 프로모션 미적용이다. CodeRabbit의 데이터 정책 인용은 공식 FAQ 원문 기준이다.
3단계 — 사람 승인과 브랜치 보호로 마무리한다
자동 리뷰가 끝나도 머지 여부는 사람이 결정하고, 그 결정이 규칙으로 강제되어야 한다.
- 브랜치 보호 규칙: main 직접 push 금지, PR 필수, 승인 1건 이상, 상태 검사(CI) 통과 필수
- AI가 승인 코멘트를 남길 수 있게 했다면 “AI 리뷰는 승인 카운트에서 제외”하고 사람 어프루브만 요구하도록 설정한다
- 인증·권한·스키마·외부 연동 변경은 라벨(
review:required등)로 트리거해 사람 승인을 강제한다 - 에이전트 동작 지침은 AGENTS.md·CLAUDE.md에 “검수 가능한 커밋 단위” 규칙으로 명문화한다
- 머지 커밋 메시지에 검수자를 남긴다 — “AI는 코드를 쓰고 검토할 수 있지만, 머지 책임은 이름이 명시된 사람이 진다”
비용 시뮬레이션: 5인 팀 기준
개발자 5명이 한 달에 완료된 리뷰 실행 100회를 균등하게 쓰는 경우를 가정해 계산했다(업계 평균이 아니라 비교용 가정이다).
| 구성 | 월 비용 | 계산 |
|---|---|---|
| GitHub Copilot Business | $95 | $19 × 5석 — 코드 리뷰 포함, 추가 요금 없음 |
| CodeRabbit Essentials | $120 | $24 × 5개발자 (연간 결제 기준) |
| Greptile Pro | $150 | $30 × 5석 (크레딧 초과 시 별도) |
| PR-Agent 셀프호스팅 | 모델 API 비용만 | 모델 사용량에 따라 변동. 내부 코드가 외부로 나가지 않는 유일한 구성 |
구독 에이전트(Claude/Codex)를 이미 쓰고 있다면 새 도구를 더 붙이기 전에, PR 생성 전 로컬 검토부터 시작하는 게 비용과 데이터 경계 양쪽에서 유리하다.
자주 묻는 질문
AI 리뷰 도구만 쓰면 사람 리뷰는 없애도 되나?
아니요. AI 리뷰는 스타일·명백한 버그 패턴·보안 초기 스크리닝에 강하고, 비즈니스 로직 정확성·아키텍처 결함·암묵적 팀 지식 판단에 약하다. 공식 문서와 도구 벤더 모두 “사람 최종 검토 필수”를 전제로 설명한다. 사람 승인 게이트를 없애는 방향은 권하지 않는다.
사내 코드가 외부로 나가는 게 걱정되면?
두 가지 선택지가 있다. (1) PR-Agent를 셀프호스팅해 모델을 직접 지정한다 — Ollama 등 로컬 모델 연동도 공식 지원된다. (2) 외부 리뷰 도구 없이 로컬 에이전트 + 사람 검수 조합으로 운영한다. SaaS 리뷰 도구는 코드가 해당 업체와 그 모델 제공사(OpenAI·Anthropic 등)로 전달된다는 점을 계약·보안 검토 전에 확인해야 한다.
에이전트가 만든 커다란 커밋은 어떻게 나누나?
되돌리기 어려운 정도를 기준으로 위험등급을 매기고, 기능 단위로 PR을 다시 구성한다. git add -p로 청크를 나누거나, 에이전트에게 “이 변경을 검수 가능한 단위로 커밋을 분할하라”고 재지시하는 방법이 실무적으로 쓰인다. 분할 자체를 에이전트에게 맡길 때는 결과 diff를 반드시 사람이 훑는다.
CodeRabbit이 Greptile보다 나은가?
목적에 따라 다르다. CodeRabbit은 설정 파일(.coderabbit.yaml)로 경로별 리뷰 규칙·무시 패턴을 팀 단위로 다듬을 수 있고 학습 기능이 있다. Greptile은 저장소 전체 맥락을 읽는 데 강점을 둔다. 소규모 팀이라면 Copilot에 포함된 코드 리뷰로 시작해 부족함이 확인될 때 전문 도구를 검토하는 순서가 비용상 합리적이다.
참고자료
- GitHub Copilot 플랜 및 코드 리뷰 포함 여부 — https://docs.github.com/en/copilot/get-started/plans (2026-10-05 확인)
- CodeRabbit 요금제 — https://www.coderabbit.ai/pricing (2026-10-05 확인)
- CodeRabbit 데이터 프라이버시 FAQ — https://docs.coderabbit.ai/faq (2026-10-05 확인)
- Greptile 요금제 — https://www.greptile.com/pricing (2026-10-05 확인)
- Codex 플랜 및 코드 리뷰 클라우드 통합 — https://developers.openai.com/codex/pricing (2026-10-05 확인)
- Claude Code PR 워크플로 지침 — https://code.claude.com/docs/en/common-workflows (2026-10-05 확인)
- PR-Agent (오픈소스, MIT) — https://github.com/The-PR-Agent/pr-agent (2026-10-05 확인)
- Anthropic 요금제 — https://www.anthropic.com/pricing (2026-10-05 확인)