로컬 LLM용 RAM·VRAM은 모델 이름의 파라미터 수만 보고 고르면 부족하기 쉽다. 실제 GGUF 파일 크기 + 목표 컨텍스트의 KV 캐시 + 연산 버퍼 + 운영체제 여유를 합산해야 한다. 배치 1과 8K 컨텍스트를 기준으로 보면 Q4 8B는 8GB가 빠듯하고 12~16GB가 편하며, Q4 32B는 24GB가 경계선이고 32GB급이 안전하다. 2026년 10월 현재 주의할 점이 두 가지다. 먼저 gpt-oss·Qwen3.8·Nemotron 3.5 Bolt처럼 MoE나 하이브리드 어텐션 구조가 늘면서 “파라미터 수 → 메모리” 공식이 어긋나는 모델이 생겼다. 이 글 중간 구조별 섹션에서 따로 다룬다. 또 하나는 램 가격이 1년 새 3~4배 오르면서 용량 선택이 곧 비용 결정이 됐다는 점이다. 마지막 구매 판단 섹션에서 계산 예시와 함께 정리한다.
핵심 요약
- Q4는 정확히 4비트가 아니다. Q4_K_M에는 스케일과 보조 데이터가 들어가므로 실제 파일이 단순 계산보다 크다.
- 컨텍스트는 별도 비용이다. 가중치를 Q4로 줄여도 KV 캐시는 기본 F16일 수 있고 토큰 수에 따라 커진다.
- RAM과 VRAM은 합산하지 않는다. 전용 GPU는 별도 풀이고 Apple Silicon은 OS와 GPU가 하나의 통합 메모리를 공유한다.
- 경계 용량은 피한다. 파일과 KV 합계에 15~30% 실행 여유를 더하고 OS용 메모리도 남긴다.
- 2026년형 모델은 구조까지 본다. MoE는 총 파라미터는 크지만 활성 파라미터와 실행 메모리가 작고, 하이브리드 어텐션은 KV 캐시 자체를 줄인다. 네이티브 저비트 양자화 모델은 총 파라미터가 커도 파일 크기가 작다.
- 2026년 10월은 용량이 곧 비용이다. DDR5 32GB 소매가가 79만원대로 오른 상태에서 32GB→64GB 추가는 예산 판단이 필요하다.
먼저 계산식부터 잡는다
가장 단순한 가중치 계산은 파라미터 수 × bits/weight ÷ 8이다. 그러나 이 값은 이론상 하한에 가깝다. GGUF 양자화는 블록별 스케일과 메타데이터를 포함하고 일부 텐서는 더 높은 정밀도를 쓸 수 있다. 구매나 배치 판단에는 모델 카드의 파라미터 수보다 내려받을 정확한 GGUF 파일 크기를 쓰는 편이 안전하다.
실행 장치 메모리 ≈ 가중치 W + KV 캐시 K + 연산·그래프 버퍼 C
보수적 모델 예산 ≈ (실제 GGUF + 목표 KV) × 1.15~1.30
시스템·통합 메모리에서는 OS와 다른 앱의 여유를 별도로 확보
여기서 15~30%는 포맷이 보장하는 상수가 아니라 OOM을 피하기 위한 계획 범위다. 백엔드, 배치 크기, GPU 커널, Flash Attention, 멀티모달 projector에 따라 실제 버퍼가 달라진다.
8B·14B·32B·70B 실제 GGUF 크기 비교
2026년 10월 22일 Hugging Face 파일 크기를 다시 확인한 대표값이다. 8B와 70B는 Llama 3.1 Instruct, 14B와 32B는 Qwen2.5 Instruct 양자화 파일을 기준으로 했다. 같은 모델급이라도 구조와 양자화 도구에 따라 크기가 달라질 수 있다.

출처: Hugging Face GGUF 파일, llama.cpp 자료
| 모델급·대표 모델 | Q4_K_M 실제 파일 | Q8_0 실제 파일 | 8K F16 KV |
|---|---|---|---|
| 8B · Llama 3.1 | 4.92GB (4.58GiB) | 8.54GB (7.95GiB) | 약 1.0GiB |
| 14B · Qwen2.5 | 8.99GB (8.37GiB) | 15.70GB (14.62GiB) | 약 1.5GiB |
| 32B · Qwen2.5 | 19.85GB (18.49GiB) | 34.82GB (32.43GiB) | 약 2.0GiB |
| 70B · Llama 3.1 | 42.52GB (39.60GiB) | 74.98GB (69.83GiB) | 약 2.5GiB |
| 20B MoE · gpt-oss-20b | 11.62GB (10.83GiB) | 12.11GB (11.28GiB) | 0.2GiB 미만(슬라이딩 윈도우) |
| 27B 하이브리드 · Qwen3.8-27B | 16.46GB (15.33GiB) | — | 약 0.2GiB(어텐션 4계층) |
| 24B MoE · LFM2.5-24B-A2B | 14.53GB (13.53GiB) | 25.49GB (23.74GiB) | 약 0.2GiB(컨볼루션 30계층) |
| 74B MoE·네이티브 IQ2 · Nemotron 3.5 Bolt 24GB | 22.02GB (20.51GiB) — IQ2 원본 | — | 약 0.2GiB(Mamba-2 하이브리드) |
GB는 10진 단위이고 GiB는 2진 단위다. 그래픽카드의 표기 용량과 도구의 출력 단위가 섞이면 경계에서 오판하기 쉬우므로 최종 판단은 byte 또는 GiB로 맞춰 다시 계산해야 한다.
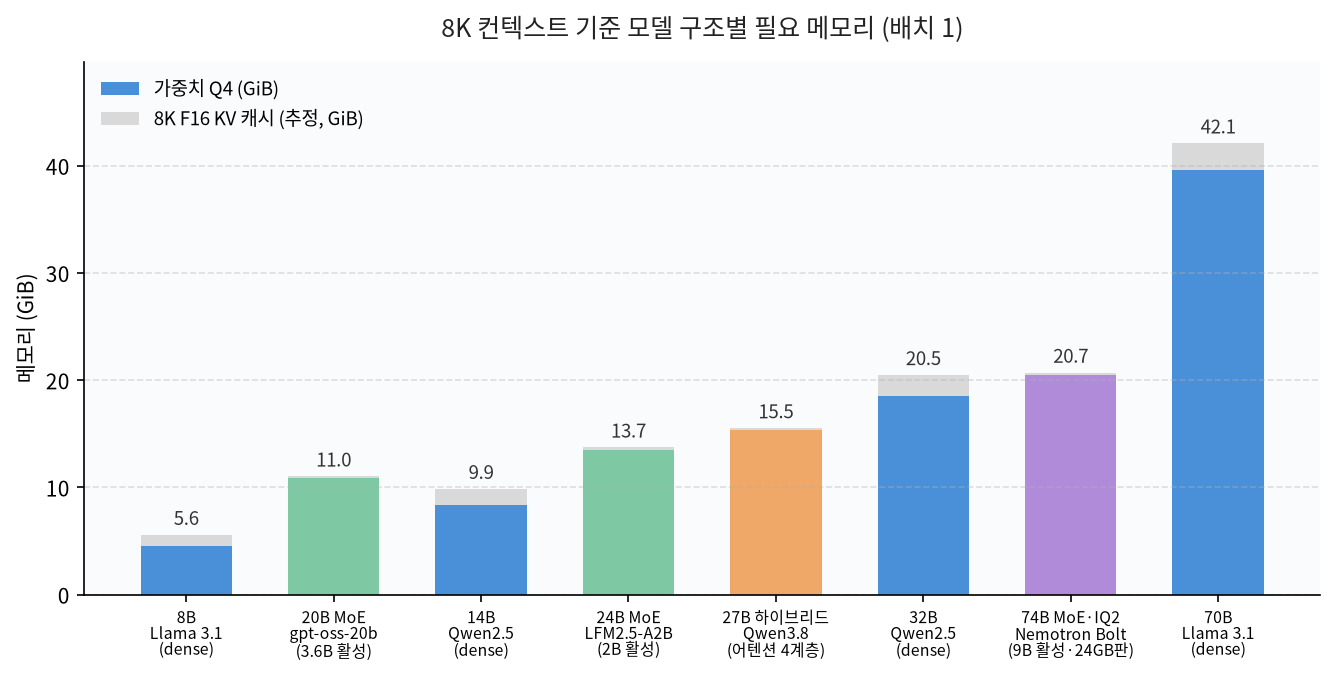
출처: Hugging Face GGUF 파일 크기(2026년 10월 22일 확인), KV 캐시는 배치 1·8K 기준 추정치
컨텍스트가 길어지면 KV 캐시가 커진다
KV 캐시는 이미 처리한 토큰의 Key와 Value를 레이어별로 보관한다. 일반적인 decoder-only Transformer에서는 아래 식으로 근사할 수 있다.
KV bytes ≈ 2 × layers × tokens × KV_heads × head_dim × bytes_per_element × batchGQA나 MQA 모델은 attention head보다 KV head 수가 적어 캐시가 줄어든다. 따라서 파라미터 수만으로 KV 메모리를 정확히 계산할 수 없고 모델의 config.json에서 레이어 수, KV head 수, head dimension을 확인해야 한다.
| 대표 모델급 | 8K F16 KV | 32K F16 KV | 128K F16 KV |
|---|---|---|---|
| 8B | 1.0GiB | 4.0GiB | 16.0GiB |
| 14B | 1.5GiB | 6.0GiB | 24.0GiB |
| 32B | 2.0GiB | 8.0GiB | 32.0GiB |
| 70B | 2.5GiB | 10.0GiB | 40.0GiB |
표는 배치 1인 대표 GQA 구조의 설명용 계산값이다. sliding-window attention은 일부 레이어의 증가가 창 크기에서 멈출 수 있고, 동시 요청과 병렬 시퀀스는 사용량을 다시 늘린다. Qwen3.8처럼 어텐션 레이어 일부만 두는 하이브리드 구조는 이 표보다 KV 캐시가 훨씬 작게 나타날 수 있다.
Ollama 공식 문서는 2026년 8월 11일 기준 VRAM 24GiB 미만에서 4K, 24~48GiB에서 32K, 48GiB 이상에서 256K를 기본 컨텍스트로 안내한다. 또한 에이전트·코딩 도구처럼 긴 문맥이 필요한 작업은 64K 이상을 권하며, 컨텍스트를 늘리면 메모리 요구량도 증가한다고 명시한다. 설치 버전과 설정이 다를 수 있으므로 ollama ps의 실제 CONTEXT를 확인해야 한다.
2026년형 구조: MoE·하이브리드·네이티브 저비트는 계산이 달라진다
최근 로컬 실행 인기 모델은 전통적인 dense GQA 구조만이 아니다. 실행 메모리 계산을 바꾸는 변화가 세 가지다.
MoE: 총 파라미터는 크지만 활성은 작다
OpenAI gpt-oss-20b는 총 21B 파라미터 중 추론 시 활성되는 파라미터가 3.6B인 MoE 구조다. 21B라는 숫자만 보면 14B dense보다 무겁다고 예상하지만, MoE 레이어가 네이티브 MXFP4로 학습되어 16GB 메모리 안에서 실행되도록 설계됐다고 공식 문서는 밝힌다. 실제 GGUF 크기도 Q4_K_M 11.62GB, Q8_0 12.11GB로 양자화 단계 간 차이가 작다. 다만 총 파라미터 전체가 메모리에 상주해야 하므로 “활성 3.6B니까 8GB면 충분하다”는 성급한 결론은 금물이다.
2026년 10월에는 같은 계열이 더 극단으로 갔다. LiquidAI LFM2.5-24B-A2B는 총 24B에 활성 2B로, Q4_K_M 파일이 14.53GB다. 40개 레이어 중 30개가 double-gated short convolution 블록이고 GQA는 10개뿐이라 KV 캐시 부담도 작다. NVIDIA Nemotron 3.5 Bolt 74B-A9B 24GB판은 총 74B에 활성 9B인 Mamba-2–Transformer 하이브리드 LatentMoE를 양자화 인식 학습(IQ2, 2비트)으로 압축해 GGUF 파일이 22.02GB다. 74B 모델이 24GB 메모리에 들어간다는 것이 이 모델의 공식 설계 목표다. “파라미터 수 × 비트 ÷ 8” 근사식으로는 이런 크기가 나올 수 없다.
하이브리드 어텐션: KV 캐시 자체를 줄인다
Qwen3.8-27B는 64개 레이어 중 어텐션 레이어가 일부(1:16 비율의 gated attention)이고 나머지는 linear attention(Gated DeltaNet)을 쓰는 하이브리드 구조다. Linear attention 구간은 토큰 수에 비례해 KV 캐시가 커지지 않으므로, 같은 27B급 dense 모델과 비교하면 긴 컨텍스트에서 KV 부담이 크게 줄어든다. 262,144 토큰의 네이티브 컨텍스트를 제공하는 것도 이 구조의 영향이 크다. 파일 크기 자체는 UD-Q4_K_M 16.46GB(15.33GiB)로 32B dense보다는 가볍고 14B보다는 무겁다. Nemotron의 Mamba-2 블록도 같은 원리로 상태 크기가 토큰 수에 선형으로만 늘어난다.
세 가지 구조 모두 “파라미터 수 × 비트 ÷ 8” 근사식으로는 예측할 수 없는 동작을 보인다. 신형 모델을 로컬로 도입할 때는 모델 카드의 구조(MoE 여부, 활성 파라미터, 어텐션 방식, 네이티브 양자화 정밀도)와 실제 GGUF 크기를 함께 확인해야 한다.
용량별 현실적인 시작점
다음 표는 완전 GPU 가속 또는 Apple 통합 메모리에서 모델을 여유 있게 상주시키는 시작점이다. Q4_K_M, F16 KV, 8K 컨텍스트, 배치 1을 기준으로 하고 버퍼와 운영체제 여유를 반영했다.
| 목표 모델 | 가중치+KV 원시 합 | 빠듯한 경계 | 권장 시작점 |
|---|---|---|---|
| 8B Q4 | 약 5.58GiB | 8GB | 12~16GB |
| 14B Q4 | 약 9.87GiB | 12GB | 16GB |
| 32B Q4 | 약 20.49GiB | 24GB | 32GB |
| 70B Q4 | 약 42.10GiB | 48GB | 64GB |
| 74B MoE·IQ2 (Nemotron 24GB판) | 약 20.7GiB | 24GB | 32GB |
이 표의 “권장”은 속도나 품질을 보장하는 제품 추천이 아니다. 32B Q4를 32K로 늘리면 F16 KV만 약 8GiB가 되어 원시 합이 약 26.5GiB로 커진다. 70B Q4를 32K로 쓰면 원시 합만 약 49.6GiB이므로 48GB 장치에는 맞지 않는다.
Q8 KV 캐시는 F16의 대략 절반, Q4 KV는 대략 4분의 1을 쓰도록 줄일 수 있지만 메타데이터 때문에 정확히 50%와 25%는 아니다. Ollama는 OLLAMA_KV_CACHE_TYPE, llama.cpp는 --cache-type-k와 --cache-type-v로 타입을 조정할 수 있다. 메모리 절약과 품질·지연시간의 trade-off를 실제 프롬프트로 확인해야 한다.
2026년 10월, 용량 선택은 비용 계산이다
계산식이 맞아도 지금은 예산 현실이 다르다. 다나와 조회 기준 삼성전자 DDR5-5600 소매 최저가가 16GB 약 35만원, 32GB 약 79만원이다. 1년 전보다 3~4배 오른 수준이고, 10월에도 상승 방향이다. 같은 계산에서 “32GB면 32B Q4가 안전하다”고 끝낼 수 없는 이유가 여기 있다. 모델이 들어가는지가 아니라 그 용량을 지금 사는 것이 합리적인지까지 판단해야 한다.
현실적인 판단 순서는 이렇다. 첫째, 기존 시스템에 남은 슬롯과 용량부터 확인한다. 증설이면 DDR5 32GB 1개가 추가되는 구조이므로 부품값이 곧 증분 비용이다. 둘째, 목표 모델의 원시 합을 계산해 기존 용량으로 컨텍스트·KV 양자화 조정으로 들어가는지 먼저 본다. 32B Q4 8K가 빠듯한 24GB 장비라도 KV를 Q8로 줄이고 컨텍스트를 8K로 유지하면 원시 합이 약 19.5GiB로 내려가 실행 여유가 생긴다. 셋째, 부족분이 크면 구조가 다른 모델로 대체 가능한지 본다. MoE·네이티브 저비트 계열은 같은 총 파라미터에 필요 메모리가 작다. gpt-oss-20b(Q4 10.83GiB)나 Nemotron 24GB판(20.51GiB)은 14B~32B dense가 필요로 하는 용량대에서 더 큰 파라미터급을 실행한다. 넷째, 여기까지 안 되면 용량 증설이 남는데, 지금 가격에서는 희소성 있는 결정으로 다뤄야 한다. 구체적인 가격 흐름과 하락 전환 판정 기준은 DDR5 램 가격 전망 글에서 다룬다.
전용 GPU와 Apple 통합 메모리는 계산이 다르다
NVIDIA·AMD 전용 GPU
시스템 RAM 32GB와 VRAM 12GB를 더해 44GB GPU처럼 계산하면 안 된다. 완전 GPU offload에서는 가중치, KV, GPU 버퍼가 VRAM에 맞아야 한다. llama.cpp의 CPU·GPU hybrid inference로 일부 레이어를 시스템 RAM에 둘 수 있지만 PCIe 경계를 오가므로 완전 상주보다 느려질 수 있다.
Apple Silicon 통합 메모리
Apple Silicon은 CPU와 GPU가 하나의 통합 메모리 풀을 공유한다. 64GB Mac이 RAM 64GB와 VRAM 64GB를 따로 제공하는 구조가 아니다. macOS, 브라우저, 모델 가중치, KV 캐시, GPU 버퍼가 같은 64GB를 놓고 경쟁한다. 구매 후 증설도 불가능하므로 모델 예산을 꽉 채우지 말고 최소 15~25% 또는 4~8GiB 이상의 OS 여유를 남기는 편이 안전하다.
통합 메모리 구조에서는 용량만큼 대역폭이 생성 속도를 가른다. 2026년 9월 22일 출시된 맥미니를 Apple 한국 공식 스펙으로 확인하면 M6은 16·24GB 구성이 153GB/s, 32GB 구성이 170GB/s, M5 Pro는 24~64GB 전 구성 307GB/s다. 토큰 생성은 가중치를 매 토큰 읽어야 하는 메모리 바운드 작업이므로 같은 모델을 돌려도 대역폭이 약 2배면 생성 속도도 유리해지는 경향이 있다. 가중치·KV 계산으로 “용량은 충분하다”고 나와도 대역폭이 낮으면 느리게 돌아갈 수 있어 예산 계산과 별개로 확인할 항목이다.
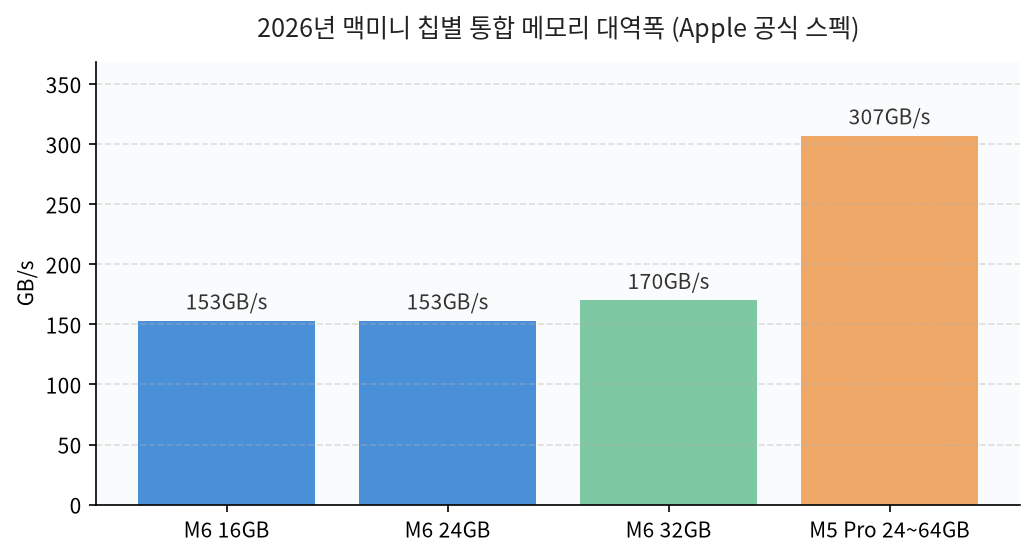
출처: Apple Mac mini 공식 스펙 (2026년 10월 2일 확인)
macOS는 Metal GPU에 쓸 수 있는 메모리 상한을 recommendedMaxWorkingSetSize로 별도로 정하고 통상 설치 메모리의 약 75% 수준으로 잡는다. llama.cpp·Ollama 계열 런타임은 이 값을 하한선처럼 다루므로, 예를 들어 24GB 구성에서는 가중치와 KV를 합쳐도 GPU가 실제로 쓸 수 있는 영역이 그보다 작다고 계산해야 한다. 시스템 여유와 이 상한을 모두 반영하면 “파일은 맞는데 실행이 안 되는” 경계 실패를 줄일 수 있다.
CPU-only와 부분 offload
CPU-only에서는 가중치와 KV가 시스템 RAM에 들어간다. llama.cpp의 기본 mmap은 모델 파일을 메모리 매핑해 불필요한 복사를 줄일 수 있지만 디스크가 물리 메모리를 대체하는 것은 아니다. working set이 RAM에 맞지 않아 swap과 page fault가 반복되면 생성 속도가 급격히 떨어질 수 있다.
구매·배치 전 7단계 체크리스트
- 모델 페이지에서 정확한 GGUF 변형과 파일 크기를 확인한다. Q4라는 이름만 보지 말고 Q4_K_M 같은 세부 타입까지 기록한다.
config.json에서 레이어 수, KV head 수, hidden size, attention head 또는 head dimension을 확인한다.- 모델 최대 컨텍스트가 아니라 실제 프롬프트와 생성 토큰을 합친 목표 컨텍스트를 정한다.
- 서버라면 동시 시퀀스와 배치 수를 반영한다. 단일 사용자 계산을 그대로 복사하지 않는다.
- 실제 GGUF와 KV를 합친 뒤 런타임 버퍼 15~30%를 잡는다.
- 전용 VRAM은 10~20%, 시스템·통합 메모리는 OS와 앱을 위해 15~25% 여유를 둔다.
- 실행 뒤
ollama ps나 llama.cpp 시작 로그에서 실제 CONTEXT, CPU/GPU split, 메모리 사용량을 확인한다.
OOM이 나면 컨텍스트·batch·parallel 축소 → Flash Attention 확인 → KV Q8/Q4 검토 → 더 작은 양자화 → 일부 CPU offload 순서로 좁히는 편이 원인 확인에 유리하다. 여러 설정을 한 번에 바꾸면 어느 항목이 효과를 냈는지 알기 어렵다.
관련 글
- AI 개발용 RAM 용량 가이드 2026 — 개발 PC 전체 메모리를 32·64·96·128GB로 고르는 기준을 다룬다.
- OpenClaw 설치 가이드: 맥미니로 개인 AI 에이전트 서버 구축하기 — 개인 서버 구성 흐름과 운영 항목을 이어서 볼 수 있다.
- 2026년 하반기 LLM 비교 — 로컬 실행과 API 사용을 비용·성능 관점에서 비교할 때 참고할 수 있다.
- 맥미니 로컬 LLM 어디까지 될까? — Apple 통합 메모리 관점에서 메모리 용량별 모델 선택 기준을 다룬다.
- 램 가격 언제 내려갈까? DDR5 구매 타이밍 — 메모리 용량을 정한 뒤 실제 구매 시점을 판단할 때 참고한다.
- DDR5 램 가격 전망 2026 — 2026년 10월 소매·칩 현물가와 하락 전환 판정 기준을 다룬다.
- VRAM 크기별 양자화 고르기 — 용량이 정해졌을 때 Q4_K_M·IQ 계열을 고르는 기준을 다룬다.
- 램 증설 vs SSD 스트리밍 — 증설 대안으로 모델을 SSD에서 스트리밍하는 방법의 속도·가격 trade-off를 다룬다.
FAQ
Q4 모델이면 파라미터 수의 절반 GB만 있으면 되는가?
아니다. 그 값은 순수 4비트 가중치의 이론값일 뿐이다. 실제 Q4_K_M 파일에는 스케일과 보조 데이터가 있고 KV 캐시, 연산 버퍼, 런타임 여유가 추가된다.
RAM 32GB와 VRAM 12GB로 32B Q4를 돌릴 수 있는가?
부분 offload로 로드될 가능성은 있지만 44GB VRAM처럼 합산할 수는 없다. 모델 일부가 시스템 RAM에 남으면 CPU·GPU 전송과 CPU 계산 때문에 속도가 낮아질 수 있다. 완전 GPU 상주가 목표라면 VRAM만으로 가중치와 KV, 버퍼가 맞는지 따로 계산해야 한다.
컨텍스트를 8K에서 32K로 늘리면 메모리도 정확히 4배가 되는가?
KV 캐시 부분은 대체로 4배가 되지만 모델 가중치는 그대로다. 전체 프로세스 메모리가 4배가 되는 것은 아니다. sliding-window 구조, KV 양자화, 백엔드 버퍼에 따라 실제 증가폭도 달라진다.
MoE 모델은 활성 파라미터만큼만 메모리를 쓰는가?
아니다. 활성 파라미터는 연산량을 줄일 뿐, 라우팅될 수 있는 전체 전문가 레이어의 가중치가 메모리에 상주해야 한다. gpt-oss-20b는 활성 3.6B지만 Q4 파일이 약 10.8GiB로, 8B dense와 14B dense 사이 용량이 필요하다.
74B 모델이 정말 24GB 메모리에서 돌아가는가?
NVIDIA Nemotron 3.5 Bolt 74B-A9B 24GB판이 그 사례다. 총 74B 중 활성 9B인 LatentMoE 구조를 양자화 인식 학습으로 2비트(IQ2) 수준까지 압축해 GGUF 파일 22.02GB로 배포한다. 다만 이는 네이티브 저비트 양자화와 Mamba-2 하이브리드 구조가 함께 적용된 특수 사례이지, 임의의 74B 모델을 Q4로 양자화해도 그만큼 줄어든다는 뜻은 아니다. 일반 dense 모델의 Q4_K_M은 여전히 파라미터급에 비례해 커진다.
램값이 이렇게 비싼데 지금 32GB 이상으로 맞추는 게 맞는가?
먼저 기존 용량에서 KV 양자화·컨텍스트 조정으로 목표 모델이 들어가는지 확인한다. 안 되면 MoE·네이티브 저비트 같은 구조적으로 가벼운 모델로 대체 가능한지 본다. 둘 다 아니면 증설인데, 2026년 10월 기준 DDR5 32GB 소매가가 79만원대이므로 용량 추가는 가격 흐름을 보고 판단할 사안이다. 하락 전환 판정 기준은 본문 구매 판단 섹션과 DDR5 전망 글에서 다룬다.
맥미니 M6으로 로컬 LLM을 돌릴 때 대역폭은 왜 중요한가?
토큰 생성은 가중치를 반복해 읽는 메모리 대역폭 작동이어서, 같은 모델·같은 양자화라도 대역폭이 높을수록 생성 속도(tok/s)가 유리해지는 경향이 있다. Apple 공식 스펙 기준 2026년 맥미니 M6은 16·24GB가 153GB/s, 32GB가 170GB/s, M5 Pro는 307GB/s다. 용량이 모델을 수용하는 “가능 여부”라면 대역폭은 “속도”를 정하는 별도 변수다.
통합 메모리 32GB면 GPU가 32GB 전부를 쓸 수 있는가?
아니다. macOS는 Metal GPU용 상한(recommendedMaxWorkingSetSize)을 설치 메모리의 약 75% 수준으로 두고 llama.cpp·Ollama 계열은 이를 상한처럼 다룬다. macOS와 다른 앱도 같은 풀을 쓰므로, 모델 예산은 용량의 70~85% 수준에서 잡는 편이 안전하다.
Apple 통합 메모리 64GB면 70B Q4에 충분한가?
8K·배치 1의 대표 계산에서는 원시 합이 약 42.1GiB라 여지가 있지만 모델과 macOS, 다른 앱이 같은 풀을 쓴다. 32K에서는 원시 합이 약 49.6GiB로 커진다. 64GB를 권장 시작점으로 볼 수는 있어도 모든 70B 모델과 컨텍스트에서 충분하다고 보장할 수는 없다. 맥미니 기준이라면 64GB 구성은 M5 Pro(307GB/s)로만 가능하므로 대역폭 걱정은 적은 편이지만, macOS GPU 상한(~75%)과 OS 여유는 그대로 반영해야 한다.
참고 자료
- llama.cpp quantize README
- llama.cpp CLI README
- Ollama Context length
- Ollama FAQ
- Hugging Face Transformers KV cache
- Llama 3.1 8B GGUF
- Qwen2.5 14B GGUF
- Qwen2.5 32B GGUF
- Llama 3.1 70B GGUF
- gpt-oss-20b GGUF
- Qwen3.8-27B GGUF
- LFM2.5-24B-A2B GGUF
- Nemotron 3.5 Bolt 74B-A9B 24GB GGUF
- 다나와 DDR5-5600 32GB 검색 (소매가 확인)
수치와 문서 접근 상태는 2026년 10월 22일에 다시 확인했다. 원본 계산 구조는 2026년 8월 11일 글을 유지하되 gpt-oss·Qwen3.8 구조 섹션과 파일 크기를 갱신했고, 2026년 9월 22일 출시 맥미니의 공식 메모리 대역폭(M6 153~170GB/s, M5 Pro 307GB/s)과 macOS GPU 상한을 Apple Silicon 섹션에 추가했다. 2026년 10월 22일 갱신에서는 LFM2.5-24B-A2B·Nemotron 3.5 Bolt 24GB판을 구조 섹션·표·차트에 추가하고, 램 가격 상승 국면의 용량별 구매 판단 섹션과 FAQ 2항을 새로 넣었다. 소매가는 다나와 조회 시점에 따라 달라진다. 모델 파일과 런타임 기본값은 이후 갱신될 수 있다.