Hugging Face에서 GGUF 모델을 받으려면 Q4_K_M, Q8_0, UD-IQ3_S 같은 파일 수십 개가 한꺼번에 나온다. 8GB·12GB 카드에는 무엇을 받아야 하고, Q4와 Q8의 품질 차이는 체감될까? 결론부터 정리한다. 단일 GPU에서 코딩·에이전트 용도라면 VRAM에 들어가는 가장 높은 K-quant(Q4_K_M 이상)를 기본으로 받고, 부족하면 UD-IQ4_XS, 그 아래는 Q3 계열로 내려간다. 메모리가 넉넉한 상태에서 “그래도 Q8이 더 정확하지 않을까” 하며 Q8_0를 받는 건 27B급에서는 공간 낭비일 확률이 높다. 이유는 아래 품질 데이터에서 확인한다.
핵심 요약
- 기본값은 Q4_K_M(또는 UD-Q4_K_M) — PPL 손실이 측정 한계 수준이고 Q8과의 차이는 소수점 셋째 자리다.
- VRAM이 부족하면 양자화를 낮추기 전에 KV 캐시 q8_0 + MoE CPU 오프로드로 Q4를 유지한다.
- 3비트(IQ3~Q3_K)는 손실이 시작되는 구간, 2비트 이하는 에이전트·도구 호출 용도로 금지다.
- gpt-oss처럼 원본이 4비트 MoE로 학습된 모델은 Q8과 Q4의 크기 차가 없어 Q8_0도 무방하다.
- IQ3 이하로 내려가야 한다면 모델을 작은 것(9B·14B Q4)으로 바꾸는 편이 품질이 낫다.
핵심 요약 — 30초 결론
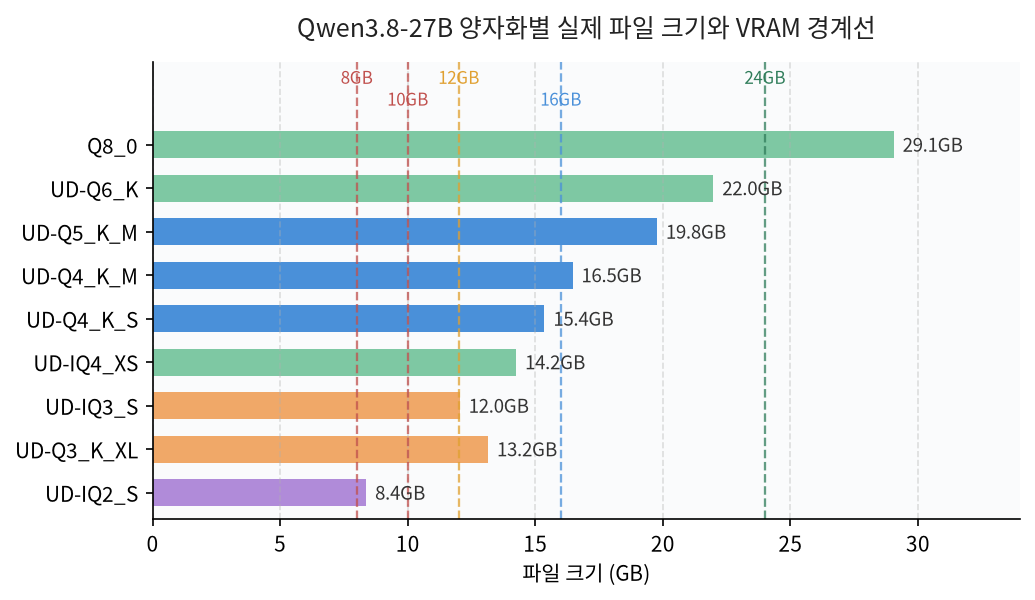
VRAM별 기본 선택 (Qwen3.8-27B 기준 실제 파일 크기)
| 내 VRAM | 받을 양자화 | 실제 파일 크기 | 근거 |
|---|---|---|---|
| 24GB (4090·5090 등) | UD-Q6_K 또는 Q8_0 | 22.0~29.0GB → KV 캐시 포함 시 경계 | 파일은 들어가지만 긴 컨텍스트에서 KV 캐시가 밀어낸다 |
| 16GB (4060 Ti 16G·5060 Ti 16G) | UD-Q4_K_M (16.5GB) → 안전하게는 UD-Q4_K_S (15.4GB) | 15.4~16.5GB | 4비트 K-quant는 품질 저하가 사실상 없는 기본값 |
| 12GB (3060 12G·4070·5070) | UD-Q4_K_S (15.4GB) | 15.4GB → 레이어 일부 CPU 오프로드 | Q4_K_M 16.5GB는 12GB에 안 들어간다 |
| 10GB (3080 10G) | UD-IQ3_S (12.0GB) | 12.0GB | 3비트 i-quant는 압축 손실이 시작되는 구간 |
| 8GB (기본형 카드) | UD-Q3_K_XL (13.1GB) — 또는 모델 자체를 9B로 | 13.1GB | 8GB에서 27B는 무리, 9B Q6_K(7.5GB)가 현실적 |
출처: Unsloth Qwen3.5-122B-A10B GGUF 벤치마크
Q4 vs Q8, 품질 차이는 얼마나 되나
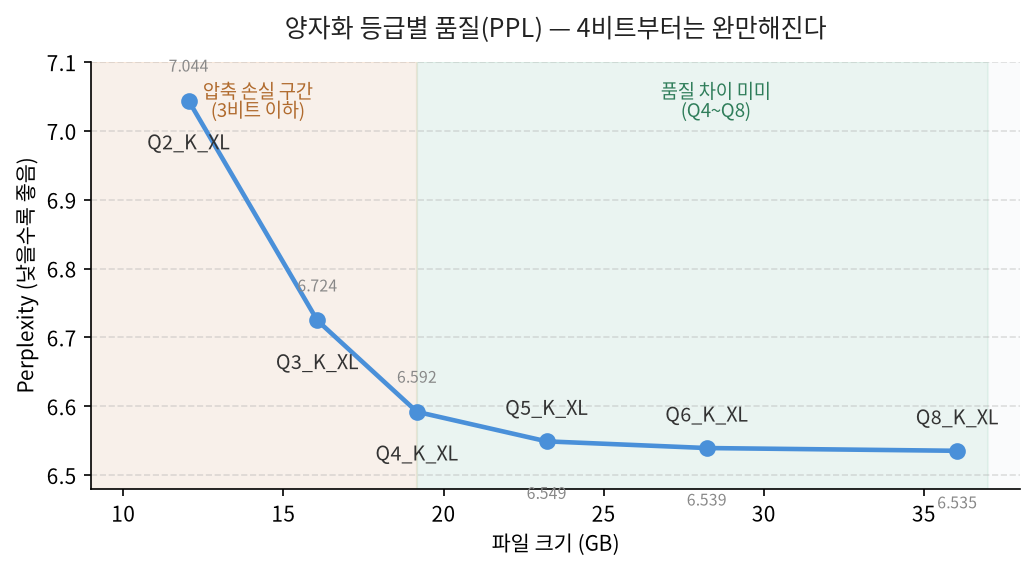
품질 근거는 2026년 Unsloth가 여러 양자화 제공자를 같은 기준으로 비교한 공식 벤치마크(Qwen3.5-122B-A10B, Wiki-text 기반 PPL·KL 발산)를 본다. 같은 모델을 누가 어떤 방식으로 양자화했는지에 따른 차이까지 함께 보인다.
| 양자화 (Unsloth Dynamic) | 파일 크기 | PPL | 평균 KL 발산 |
|---|---|---|---|
| BF16 원본 수준 | — | 6.53 부근 | — |
| Q8_K_XL | 36.0GB | 6.5352 | 0.0026 |
| Q6_K_XL | 28.2GB | 6.5392 | 0.0041 |
| Q5_K_XL | 23.2GB | 6.5489 | 0.0069 |
| Q4_K_XL | 19.2GB | 6.5918 | 0.0137 |
| Q3_K_XL | 16.1GB | 6.7245 | 0.0308 |
| Q2_K_XL | 12.0GB | 7.0438 | 0.0970 |
Q8과 Q4의 PPL 차이는 0.056, 평균 KL 발산 차이는 0.011이다. 반면 Q4→Q3으로 내려가면 PPL이 0.13 벌어지고 Q3→Q2에서 0.32 더 벌어진다. 즉 4비트까지는 완만하고, 3비트부터 기울기가 커지며, 2비트에서 품질이 무너진다는 구조다. 이것이 “VRAM이 허락하는 한 Q4 이상을 유지하라”는 기본 전략의 근거다.
단, 이 수치는 일상 대화·지식 질의 수준의 측정이고 에이전트·도구 호출은 더 취약하다. Unsloth가 2026년 9월 발표한 Divergence-300@32 측정(300개 미공개 프롬프트로 BF16 대비 32토큰 궤적 일치율 측정)에서는 2비트 이하에서 급락이 시작된다 — UD-Q2_K_XL 약 25% → UD-IQ2_S 8~10% 미만. 즉:
- Q4_K_M~Q6_K 구간: 측정 가능한 품질 손실이 사실상 없다. VRAM이 부족해서 Q8을 포기할 이유가 없다.
- Q3_K~IQ3 구간: 대화·요약은 유지되지만 긴 추론·도구 호출에서 오답이 늘기 시작하는 구간. 12GB 이하 카드에서는 어쩔 수 없지만, 코딩 에이전트 용도라면 모델을 더 작은 것으로 바꾸는 편이 낫다.
- IQ2 이하: 에이전트·도구 호출 용도로는 쓰지 않는다. Unsloth 공식 문서도 “1-bit는 에이전트 유스케이스에 사용하지 말라”고 명시한다(루핑·빈 응답·도구 호출 실패).
i-quant(IQ)와 K-quant, 뭐가 다른가
같은 비트 수라면 두 계열이 파일 크기와 품질이 다르다.
- K-quant (Q4_K_M, Q5_K_S…): 블록 단위 스케일링. llama.cpp 오리지널. 속도가 빠르고 호환성이 좋다.
- i-quant (IQ4_XS, IQ3_S…): 중요도 행렬(imatrix) 기반. 같은 크기에서 품질이 더 좋지만, 캘리브레이션 데이터에 의존하고 양자화 시간이 오래 걸린다. 극한 압축(3비트 이하)에서 K-quant보다 유리하다.
- UD- 접두사 (UD-Q4_K_M 등): Unsloth Dynamic 3.0. 레이어별 중요도를 차등 배분해 같은 크기의 타 제공자 양자화 대비 최대 +10% top-1 정확도를 낸다고 unsloth가 밝혔다(2026-09). 같은 크기의 plain Q4_K_M이 있다면 UD-를 우선한다.
실제 선택은 “정확도 곡선의 무릎”에서 한다. 4비트까지는 거의 수평이고, 3비트부터 기울어지고, 2비트에서 무너진다. 따라서 VRAM 예산 안에서 무릎 위(4비트 K-quant)에 머무는 것이 정답이고, 예산이 안 되면 모델 크기를 낮춰 다시 4비트로 맞춘다.
출처: Hugging Face 파일 크기 실측 (2026-10-08)
2026년형 모델은 규칙이 다르다 — MoE·하이브리드
최근 로컬 모델은 dense 27B보다 gpt-oss-20b(21B 총 파라미터·3.6B 활성)나 Qwen3.8-Flash-Next(125B 총·6B 활성) 같은 MoE가 늘었다. 양자화 선택 기준이 달라진다.
gpt-oss-20b의 특수성: 이 모델은 OpenAI가 애초 MXFP4로 학습 후 양자화(post-training)했다. 그래서 Q4_K_M(11.62GB)와 Q8_0(12.11GB)의 차이가 0.5GB에 불과하다 — MoE 가중치가 이미 4비트로 압축돼 있어 Q8로 올려도 줄어들 게 없다. gpt-oss-20b는 Q8_0를 받아도 된다. 공식 문서도 “All evals were performed with the same MXFP4 quantization”이라고 밝힌다. 단 16GB 미만 카드라면 UD-Q4_K_XL(11.87GB)로 내려가고 이때도 손실은 거의 없다.
Flash-Next 같은 거대 MoE: 125B 총 파라미터 모델의 Q4_K_XL이 103.7GiB다. 단일 소비자 GPU는 커녕 워크스테이션도 아니다. “활성 6B니까 가볍겠지”하고 받으면 74GB짜리 IQ1_M을 내려받게 된다. 총 파라미터 전체가 메모리에 상주해야 하므로 MoE는 총 파라미터 크기로 파일을 고르고, 활성 파라미터는 속도에만 영향을 준다.
컨텍스트가 길어지면 양자화보다 KV 캐시가 먼저 문제다
27B Q4_K_M(16.5GB)을 16GB 카드에 올리고 컨텍스트를 32K로 늘리면 언젠가 OOM이 난다. 가중치 양자화와 별개로 KV 캐시는 컨텍스트에 비례해 커진다. Qwen3.8-27B는 64레이어 중 4개만 풀 어텐션(나머지 Gated DeltaNet)이라 KV 캐시가 매우 작은 편이지만, 일반 dense 모델은 8K 기준 1~2GiB, 32K에서 4~8GiB까지 간다.
이때 선택지는 둘이다.
- KV 캐시 양자화 — llama.cpp
--cache-type-k q8_0 --cache-type-v q8_0(기본 f16). 용량을 절반으로 줄인다. 단 V 캐시 q4_0는 품질 저하 보고가 있어 q8_0까지를 권장한다. - MoE 레이어 CPU 오프로드 — llama.cpp
--n-cpu-moe N. 전문가 가중치 일부를 RAM에 두고 GPU에는 어텐션만 올린다. MoE 모델을 12~16GB 카드에서 돌리는 사실상 표준 패턴이다. dense 모델엔--n-cpu-ffn이 대응한다.
즉 “VRAM 부족 → 더 낮은 양자화”만이 아니라 “KV 캐시 q8_0 + MoE 오프로드 조합으로 Q4를 유지”하는 편이 품질적으로 낫다.
VRAM별 최종 판정표
위 데이터를 종합해 한국에서 실제 구매 가능한 카드 기준으로 정리한다. (파일 크기는 2026-10-08 Hugging Face API 실측)
| 카드 (VRAM) | Qwen3.8-27B | gpt-oss-20b | 12GB 미만일 때 권장 모델 |
|---|---|---|---|
| 24GB+ | UD-Q6_K (22.0GB) | Q8_0 (12.1GB) — 여유 만점 | — |
| 16GB | UD-Q4_K_M (16.5GB) | UD-Q4_K_XL (11.9GB) | — |
| 12GB | UD-Q4_K_S (15.4GB) + KV q8_0 | UD-Q4_K_XL (11.9GB) + n-cpu-moe 일부 | — |
| 10GB | UD-IQ3_S (12.0GB) + n-cpu-moe | Q4_K_M (11.6GB) + n-cpu-moe | 14B Q4_K_M (9.0GB) |
| 8GB | 비권장 → 9B Q6_K (7.5GB) | Q3_K_M (11.5GB) + 오프로드 | 9B Q6_K, 14B Q4_K_M |
자주 묻는 질문
Q4로 받았는데 Q8과 차이를 체감할 수 있나요?
PPL 데이터상 차이는 소수점 셋째 자리다. 체감 차이는 거의 없으며, 차이를 느꼈다면 양자화가 아니라 샘플링 파라미터(temperature, top_p)나 컨텍스트 초과가 원인일 확률이 높다. Qwen3.8은 thinking 모드 temperature=1.0·top_p=0.95, instruct 모드 temperature=0.7·top_p=0.80을 공식 권장한다.
Ollama로 받으면 뭘로 받기나 하나요?
Ollama는 기본 라이브러리 모델을 Q4_K_M로 배포한다. 즉 ollama pull qwen3.8:27b로 받는 순간 이 글의 “Q4_K_M 기본값” 전략과 같다. 더 높은 정밀도가 필요하면 커뮤니티 GGUF를 직접 내려받아 Modelfile로 등록한다.
IQ4_XS와 Q4_K_S 중 뭐가 좋나요?
거의 같은 크기(14.3GB vs 14.9GB)라면 i-quant(IQ4_XS)가 이론상 같은 크기에서 더 낫다. 다만 IQ 계열은 레거시 하드웨어에서 커널 지원이 늦을 수 있으니, 구형 카드라면 Q4_K_S가 안전하다.
언제 Q8_0를 받아야 하나요?
① 24GB+ 카드에서 파일이 넉넉히 들어갈 때, ② gpt-oss처럼 원본이 이미 4비트 MoE라 Q8과 크기 차이가 없을 때, ③ 파인튜닝처럼 정밀도가 민감한 작업을 할 때다. 그 외에는 Q4~Q6의 손실이 측정 한계 수준이라 Q8의 공간이 아깝다.
2비트 양자화는 언제 쓸 수 있나요?
UD-IQ2_S(8.37GB)는 8GB 카드에서 27B를 돌리는 마지막 수단이지만, Divergence-300@32가 8~10%로 무너진다. 짧은 지식 질의만 가능하고 도구 호출·에이전트는 실패한다. 이 크기면 Qwen3.5-9B Q6_K(7.5GB)를 받는 편이 모든 면에서 낫다.
결론 — 선택은 세 단계로
- VRAM에 들어가는 가장 높은 K-quant를 받는다. 기본값 Q4_K_M. 16GB 카드면 UD-Q4_K_M, 24GB면 Q6_K.
- 안 들어가면 양자화를 낮추기 전에 KV q8_0·MoE 오프로드를 먼저 쓴다. Q4를 유지하는 편이 품질에 낫다.
- IQ3 이하로 내려가야 한다면 모델을 작은 것으로 바꾼다. 27B IQ3_S < 14B Q4_K_M가 실사용 품질 기준으로 대체로 낫다.
커뮤니티에서 반복되는 질문 “3080 10GB로 코딩 모델 뭘 받아야 하나”의 답도 이 표에서 나온다 — 27B UD-IQ3_S + n-cpu-moe로 진입하거나, 14B Q4_K_M로 안정적으로 가거나 둘 중 하나다.
참고자료
- Unsloth Dynamic 3.0 GGUF — Divergence-300@32 측정 방법과 1비트 경고
- Unsloth Qwen3.5 GGUF 벤치마크 — 양자화별 PPL·KL 발산 전체 표
- Unsloth Qwen3.8-27B-GGUF 저장소 (파일 크기 실측 원본)
- OpenAI gpt-oss-20b 모델카드 — MXFP4 post-training 양자화 명시
- llama.cpp server README — –n-cpu-moe / –cache-type-k 옵션
- Qwen3.8-Flash-Next 모델카드 — 125B 총 / 6B 활성 파라미터 구조
- 파일 크기는 2026-10-08 기준 Hugging Face API 실측값이다.
내부 링크: 로컬 LLM용 RAM·VRAM 계산은 로컬 LLM 메모리 계산법에서, GPU 구매 타이밍은 로컬 LLM용 GPU 지금 사도 될까?에서 다룬다. 맥미니 통합 메모리 기준은 맥미니 로컬 LLM 모델 선택을 참고한다.