32GB 램으로 RAM보다 큰 MoE 모델을 돌리려는 사람이 2026년 10월 지금 선택할 수 있는 길은 네 가지다. 결론부터 말하면 (1) 당장 최신 대형 모델을 안정적으로 쓰려면 구독 유지, (2) 로컬 실험 의지가 있고 램이 32GB 이상이면 SSD 스트리밍 엔진 시도, (3) 증설은 램 가격이 정점을 지나갔다고 판단될 때, (4) 그래픽카드 증설은 VRAM 싸이클이 꼬인 지금 피하는 것이 합리적이다. 램값이 1년새 94% 오른 상황에서 “모델이 램보다 커서 못 돌린다”는 더 이상 자동적으로 “램을 사야 한다”로 이어지지 않는다.
핵심 요약
- 2026년 10월 기준 DDR5 32GB 키트 최저가는 약 73만~78만 원. 2025년 12월 최저점 대비 1년새 +94%다. 이 시점에 램 증설은 비용 효율이 가장 나쁜 선택지가 됐다.
- MoE 모델은 토큰마다 일부 전문가(expert)만 활성화하므로, 전체 가중치를 램에 올리지 않고 NVMe SSD에서 필요한 전문가만 읽는 추론 방식이 등장했다. 대표 엔진이 janas, Strata, ds4(DwarfStar)다.
- janas는 32GB 램 노트북에서 48GB 크기 Qwen3-Next-80B를 초당 24~37 토큰으로 구동한다(개발자 공식 측정, 단일 기기). llama.cpp가 같은 조건에서 초당 2.8 토큰인 것과 비교된다.
- 단, 이 세 도구 모두 실험 단계다. janas는 지원 기종이 x86-64 리눅스/윈도우 + AVX2 이상 + NVMe로 제한되고 맥·AMD CPU·SATA SSD 환경은 검증되지 않았다. Strata는 그래픽카드 12GB 이상이 필요하다. ds4는 맥 96GB 이상이 기본 타깃이다.
- 코딩 AI 구독(Claude Pro 월 $20) 12개월 비용 약 32만 원은 램 키트 증설 비용보다 싸고, 실험 부담 없이 최신 모델을 쓸 수 있다. 어떤 도구도 완성품이 아니기 때문에 구독을 완전히 대체한다고 보기는 어렵다.
왜 지금 “램보다 큰 모델”이 이슈인가
로컬 LLM 사용자에게 램은 곧 “돌릴 수 있는 모델의 크기”다. 양자화로 모델을 줄여도 70B급 모델은 Q4 양자화로 40GB 안팎이라 32GB 시스템에 올리기 어렵다. 그동안의 해법은 램 증설(64GB→128GB)이었는데, AI 서버 수요로 DDR5 가격이 급등하면서 이 경로의 비용이 무너졌다.
동시에 모델 구조가 바뀌었다. Qwen3-Next·DeepSeek 계열처럼 총 파라미터는 크지만 토큰마다 활성 파라미터가 작은 MoE(Mixture of Experts) 모델이 늘었다. MoE는 토큰 생성 시 전체 전문가 중 일부만 필요하므로, 필요한 전문가만 NVMe SSD에서 읽고 자주 쓰이는 전문가는 램에 캐시하는 방식이 가능해졌다. NVMe 읽기 5GB/s대면 초당 수십 토큰 생성이 현실적으로 나온다.
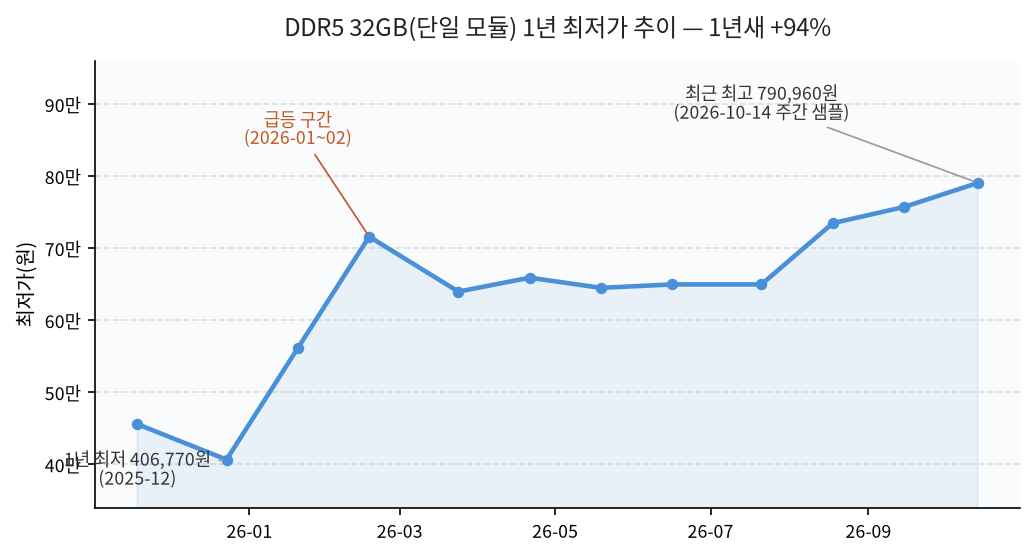
출처: 다나와 가격비교 (2026-10-15 조회, 삼성전자 DDR5-5600 32GB 주간 최저가 샘플)
이 그래프가 말하는 것은 단순하다. 2025년 12월 40.7만 원이던 DDR5 32GB가 2026년 1~2월 급등해 10월 현재 79만 원이다. “모델이 못 돌아가서 램을 산다”는 결정이 1년 전보다 두 배 비싸졌다는 뜻이다.
후보 3종: 무엇이 다른가
세 도구는 같은 문제(RAM보다 큰 모델)를 다르게 푼다.
| 구분 | janas | Strata | ds4 (DwarfStar) |
|---|---|---|---|
| 개발자/공개 | prabanta-dev, 2026-09 공개 | Niko1221, 2026-09 공개 | antirez(Redis 개발자), 2026-05 공개 |
| 핵심 방식 | 전문가를 NVMe에서 직접 스트리밍, O_DIRECT | 전문가를 램+GPU 분산, SSD는 조회 테이블 | GPU별 최적화(Metal/CUDA/ROCm) + SSD 스트리밍 |
| 대상 모델 | Qwen3-Next-80B, Qwen3.6-35B 등 | Qwen3.8-Flash-Next(125B) 고정 | DeepSeek V4 Flash/PRO, GLM 5.x |
| 최소 요구 | x86-64 Linux/Win, 16GB+(32GB 권장), NVMe 필수 | 그래픽카드 VRAM 12GB+, 램 32GB+ | 맥 96GB+(기본), CUDA/ROCm 기기 |
| 맥 지원 | 없음(x86-64 전용) | 없음 | 있음(Metal 기본 타깃) |
| 별도 그래픽카드 | 불필요(Vulkan GPU는 선택) | 필수(NVIDIA/AMD 지정 모델) | 기기별(Metal/CUDA/ROCm) |
| 성격 | 연구 실험 | 원클릭 설치 지향 | 몇 개 모델에 특화한 엔진 |
| 라이선스 | GPL v3+ | 오픈소스(무료) | 오픈소스 |
| 문서화 README 기준 성격 | 상세 측정 조건 명시 | 초보자용 안내 충실 | 실무 엔지니어링 중심 |
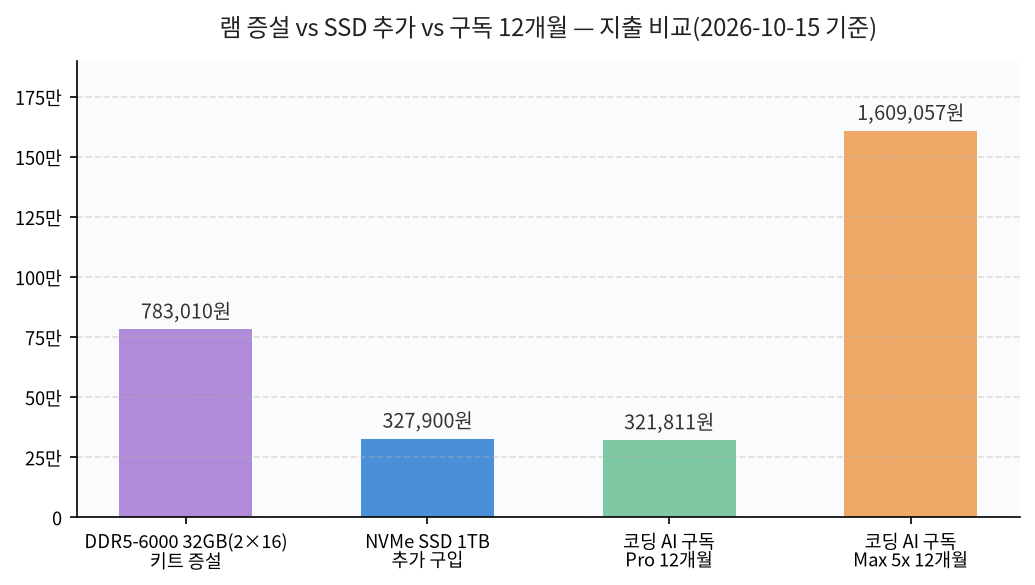
출처: 다나와 최저가(램·SSD), Anthropic 공식 요금(구독, 환율 1,340.88원 적용)
판정: 누가 무엇을 해야 하나
32GB 램 노트북/PC 사용자, 당장 대형 모델 로컬 구동이 급하다면 — janas를 실험해 볼 가치가 있다. 그래픽카드 없이 CPU+iGPU로 돌아가고, 설치는 릴리스 바이너리를 받아 압축 해제 후 janas-chat을 실행하는 것으로 끝난다. 단 지원 모델이 Qwen 계열로 좁고, 한 대의 노트북에서 측정된 수치라 내 환경에서 재측정(janas-bench)이 필수다. 최소 16GB 램, 32GB 이상 권장이며 모델은 NVMe에 둬야 한다.
게이밍 PC(VRAM 12GB+) 보유자, 최신 초대형 모델을 쓰고 싶다면 — Strata가 설치 편의성에서 앞선다. Qwen3.8-Flash-Next(125B)를 원클릭 설치로 구동하며, RTX 5070에서 초당 60~94 토큰을 낸다(공식 측정). 단 모델이 하나로 고정되고, 램 부족 시 멈춤 현상(“engine stopped unexpectedly”)이 공식 문서에 명시돼 있으니 다른 프로그램을 닫아야 한다.
맥 사용자, 96GB 이상 통합 메모리라면 — ds4(DwarfStar)가 정석이다. DeepSeek V4 Flash와 GLM 5.x를 Metal로 최적화해 구동하며, 램이 부족한 맥에서도 SSD 스트리밍을 지원한다. 32GB 맥은 타깃이 아니므로 기대하지 않는다.
아무것도 설치하기 싫고 생산성이 우선이라면 — 구독 유지가 여전히 최저비용·최고품질이다. Claude Pro 월 $20(약 2.7만 원)이면 12개월 32만 원으로, 램 키트 증설보다 싸고 최신 모델을 즉시 쓸 수 있다. 로컬 실험은 취미·학습 목적이라면 몰라도 업무 대체 수단으로 삼기엔 세 도구 모두 이르다.
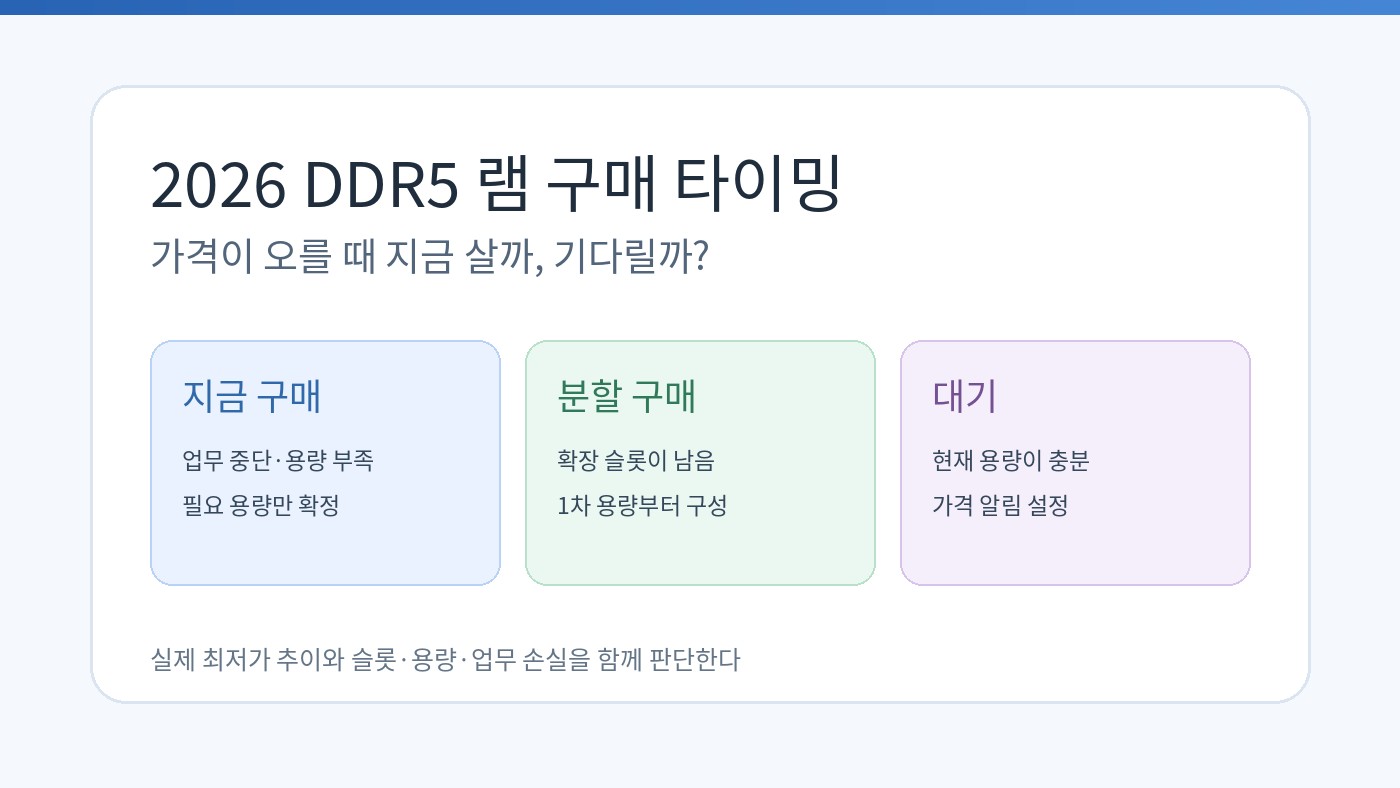
램 증설이 합리적인 경우는 — DDR5 가격이 정점을 지나 하락 국면으로 확인될 때다. 지금은 그 timing이 아니다. 램 값 추이를 계속 보고 있다면 램 그래프 보는 곳 4곳 글의 방법으로 다나와 주간 최저가를 추적하면 된다.
실패 조건 체크리스트
시도 전에 아래를 확인한다. 하나라도 걸리면 해당 도구는 아직 내 것이 아니다.
- CPU가 x86-64이고 AVX2 이상을 지원하는가 (인텔 2013년 이후, AMD 2015년 이후 — janas 기준)
- 모델 파일이 NVMe SSD에 있는가 (SATA SSD·HDD는 토큰마다 지연이 늘어난다)
- 여유 램이 16GB 이상인가 (janas 최소 요구; 대형 모델은 32GB+)
- 그래픽카드 VRAM 12GB 이상인가 (Strata 요구 — janas는 불필요)
- 맥이라면 통합 메모리 96GB 이상인가 (ds4 기본 타깃)
- 백그라운드 프로그램을 닫을 준비가 됐는가 (전문가 캐시가 여유 램을 사용한다)
- 실험 단계 도구임을 받아들였는가 (API·명령행이 주 단위로 바뀐다 — janas README 명시)
- 자기 기기에서
janas-bench등으로 재측정할 의지가 있는가 (공식 수치는 단일 기기 기준)
FAQ
램이 부족하면 SSD 스트리밍이 정답인가?
아니다. SSD 스트리밍은 “램 증설 비용을 피하는” 방법이지 램을 대체하는 만능 열쇠가 아니다. 초당 24~37 토큰은 채팅에는 충분하지만 긴 컨텍스트를 읽는 사전처리(prefill)와 에이전트 작업에는 부족하다는 지적이 HN 토론에서 나왔다. 또한 전문가 캐시 알고리즘이 모델·프롬프트 의존적이라 아직 풀린 문제가 아니라는 분석도 있다. 대량 문서 처리·에이전트 워크플로가 주 용도라면 여전히 램/VRAM이 충분해야 한다.
janas 공식 벤치마크를 그대로 믿어도 되나?
반은 믿고 반은 재측정해야 한다. 수치 자체는 측정 조건(기기, 날짜, 라운드 수)을 상세히 공개했고 llama.cpp 비교도 동일 파일·동일 기기에서 이뤄져 신뢰도가 높다. 단 한 대의 노트북(Core Ultra 9 185H, 32GB)에서 나온 값이므로 AMD CPU, 외장 그래픽카드, 느린 디스크 환경은 공식 문서 스스로 “시험된 적 없다”고 명시한다. 내 기기에서 janas-bench를 돌려 확인하는 것이 공식 권장 사용법이다.
Strata는 그래픽카드 없이도 되나?
안 된다. Strata는 NVIDIA RTX 20~50 시리즈 또는 AMD 지정 라데온(VRAM 12GB+)을 요구한다. 그래픽카드가 없거나 구형이라면 janas가 CPU+iGPU 구성을 지원하므로 이쪽이 맞다.
코딩 AI 구독을 끊고 로컬로 완전히 갈아탈 수 있나?
지금은 아니라고 본다. 로컬 MoE 스트리밍은 채팅·단문 생성에는 쓸만하지만 코딩 에이전트가 문서·코드를 대량으로 읽는 워크플로에서는 prefill 속도가 발목을 잡는다. 보안·프라이버시 이유로 코드가 외부로 나가면 안 되는 환경이라면 이야기가 달라지지만, 그 경우에도 안정성이 검증된 시점의 일이다. 당분간은 구독(메인) + 로컬(실험·민감 데이터) 병행이 현실적이다.
램 가격은 언제 떨어지나?
이 글의 범위를 벗어나지만, 기존에 쓴 DDR5 전망 글에서 다뤘다. 짧게만 요약하면 AI 서버 HBM/DDR5 수요가 공급을 계속 흡수하고 있어 단기 반등은 어렵다는 관측이 우세하다. 증설을 서두르지 말고 가격 추이를 보라는 것이 위 판정의 전제다.
함께 읽으면 좋은 글
- 로컬 LLM 양자화 뭘로 받을까? — VRAM별 Q4·Q8·IQ 선택 기준
- 로컬 LLM용 GPU 지금 사도 될까? — 5090·5070 Ti 가격 2배 급등 실측과 VRAM별 구매 판정
- 코딩 AI 구독, API로 바꾸면 진짜 쌀까? — 조합별 월 비용 손익분기 계산법
- 맥미니 로컬 LLM 메모리·모델 선택 가이드
참고 자료
- janas 공식 저장소(README·INSTALL) — 벤치마크 수치, 요구사항, 실험 단계 경고 (2026-10-15 확인)
- Strata 공식 저장소 — 요구사항, 속도 표 (2026-10-15 확인)
- ds4(DwarfStar) 공식 저장소 — 지원 하드웨어, SSD 스트리밍 조건 (2026-10-15 확인)
- Hacker News 토론: Janas — Run LLMs larger than RAM — prefill 한계·캐싱 난제 지적 (219표, 댓글 94건)
- Anthropic 요금 페이지 — Pro 월 $20(연간 결제 시 $17), Max $100~$200 (2026-10-15 확인)
- 다나와 가격비교 — DDR5 32GB 키트·삼성 DDR5-5600 32GB 주간 최저가, NVMe SSD 1TB 최저가 (2026-10-15 조회)