AI 검색 노출은 유지하고 모델 학습은 제한하려면 봇 이름이 아니라 목적을 나눠 설정해야 한다. OpenAI와 Anthropic은 학습·검색·사용자 요청용 에이전트를 각각 분리하며, Perplexity도 검색용과 사용자 요청용 에이전트를 구분한다. 따라서 검색용 OAI-SearchBot·Claude-SearchBot·PerplexityBot은 허용하고, 학습용 GPTBot·ClaudeBot은 별도로 판단하는 방식이 실용적이다. 이 글의 봇 이름·user-agent 문자열·IP 검증 주소는 각사 공식 문서를 2026-09-17에 다시 확인했다. 로그 분석과 방화벽 규칙에 바로 쓸 수 있도록 전체 user-agent 문자열과 공개 IP 목록 JSON 주소도 함께 정리한다.
핵심 요약
robots.txt는 크롤러에게 사이트 접근 규칙을 알리는 공개 표준이지 보안 장치가 아니다.- OpenAI는
GPTBot(학습),OAI-SearchBot(검색),ChatGPT-User(사용자 요청)를 구분한다. - Anthropic은
ClaudeBot(학습),Claude-SearchBot(검색),Claude-User(사용자 요청)를 구분한다. - Perplexity는
PerplexityBot(검색)과Perplexity-User(사용자 요청)를 구분하며, 공식 문서상 PerplexityBot은 기반 모델 학습용이 아니다. - 검색 노출을 원하면 검색용 봇은 허용하고 학습용 봇만 별도로 판단해야 한다.
- OpenAI·Anthropic·Perplexity는 봇 공식 IP 범위를 JSON으로 공개하므로 user-agent 위조는 IP 교차검증으로 구분한다.
- Anthropic 봇은 비표준
Crawl-delay확장을 지원해 전면 차단 없이 크롤 속도를 줄일 수 있다. - Cloudflare는 2026-09-15부터 Search·Agent·Training을 분리한 AI 봇 정책 프리셋을 신규 도메인 기본값으로 적용한다.
AI 크롤러와 일반 검색 크롤러는 무엇이 다른가
일반 검색 크롤러는 웹페이지를 발견하고 색인해 검색 결과에 노출하기 위해 움직인다. 반면 AI 크롤러는 목적이 더 다양하다. 어떤 봇은 검색형 답변에 출처를 제공하기 위해 페이지를 읽고, 어떤 봇은 모델 학습에 사용할 데이터를 수집하며, 어떤 봇은 사용자가 특정 질문을 했을 때만 페이지를 방문한다.
이 차이를 무시하고 모든 AI 봇을 한 줄로 차단하면 AI 검색 노출 기회를 잃을 수 있다. 반대로 모든 AI 봇을 열어두면 사이트 콘텐츠가 원치 않는 방식으로 수집될 수 있다. 그래서 운영 전략은 “AI 봇 전체”가 아니라 “봇의 목적”을 기준으로 나누는 편이 낫다.
GPTBot, OAI-SearchBot, ChatGPT-User는 목적이 다르다
OpenAI 공식 문서는 GPTBot과 OAI-SearchBot을 구분한다. GPTBot은 생성형 AI 기반 모델을 더 유용하고 안전하게 만들기 위한 크롤러로 설명된다. 반면 OAI-SearchBot은 검색 결과와 연결되는 봇으로 소개된다. OpenAI 문서는 웹마스터가 OAI-SearchBot은 허용하고 GPTBot은 차단하는 식의 독립적인 설정이 가능하다고 설명한다.
또 하나 중요한 이름은 ChatGPT-User이다. OpenAI 문서에 따르면 ChatGPT-User는 사용자가 ChatGPT나 Custom GPT에서 질문했을 때 웹페이지를 방문하는 사용자 요청 기반 에이전트다. 자동 웹 크롤링 용도가 아니며, 사용자 요청으로 발생하는 동작이기 때문에 일반적인 robots.txt 규칙 적용과는 다르게 볼 필요가 있다.
| 크롤러/에이전트 | 주요 목적 | 운영 판단 |
|---|---|---|
| GPTBot | 모델 개선·학습 목적 크롤링 | 학습 이용을 제한하고 싶다면 차단 후보 |
| OAI-SearchBot | 검색·답변 노출과 연결되는 크롤링 | AI 검색 노출을 원하면 허용 후보 |
| ChatGPT-User | 사용자 요청으로 특정 페이지 방문 | 자동 크롤러와 분리해 판단 |
| Googlebot | Google 검색 색인 | 일반 SEO를 위해 보통 허용 |
| ClaudeBot | Anthropic 모델 개발용 콘텐츠 수집 | 학습 이용을 제한하려면 차단 후보 |
| Claude-SearchBot | Claude 검색 결과 품질 개선 | Claude 검색 노출을 원하면 허용 후보 |
| Claude-User | Claude 사용자의 요청으로 페이지 방문 | 사용자 요청 접근 여부를 별도로 판단 |
| PerplexityBot | Perplexity 검색 결과에 사이트 노출 | 검색 노출을 원하면 허용 후보 |
| Perplexity-User | 사용자 질문에 따른 페이지 방문 | 자동 검색 크롤러와 분리해 판단 |
로그에서 진짜 AI 크롤러를 구분하려면 user-agent 문자열 전체와 출발 IP를 함께 봐야 한다. 세 회사 모두 공식 IP 범위를 JSON 형태로 공개하고 있으며, 실제 요청은 아래 문자열 형태로 온다. 버전 숫자(1.4 등)는 시간이 지나며 달라질 수 있다.
| 봇 | 전체 user-agent 문자열 예시 | 공식 IP 범위(JSON) |
|---|---|---|
| GPTBot | Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot | openai.com/gptbot.json |
| OAI-SearchBot | Mozilla/5.0 … ; compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot | openai.com/searchbot.json |
| OAI-AdsBot | Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; OAI-AdsBot/1.0; +https://openai.com/adsbot | openai.com/adsbot.json |
| ChatGPT-User | Mozilla/5.0 … ; compatible; ChatGPT-User/1.0; +https://openai.com/bot | openai.com/chatgpt-user.json |
| ClaudeBot·Claude-SearchBot·Claude-User | Anthropic은 봇별 user-agent로 활동하며 robots.txt를 준수한다고 공식 문서에 명시 | claude.com/crawling/bots.json |
| PerplexityBot | Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot) | perplexity.ai/perplexitybot.json |
| Perplexity-User | Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user) | perplexity.ai/perplexity-user.json |
주의할 점은 두 가지다. 첫째, user-agent 문자열은 요청 헤더에서 누구나 위조할 수 있으므로, 진짜 OpenAI·Anthropic·Perplexity 크롤러인지는 출발 IP가 공식 JSON 범위 안에 들어있는지 교차검증해야 한다. 둘째, OpenAI 봇이 robots.txt 파일 자체를 요청할 때는 문자열에 robots.txt 마커가 붙을 수 있다. 로그에 경로가 없어도 이 마커로 요청 목적을 구분할 수 있다.
ClaudeBot과 PerplexityBot도 역할별로 나눠야 한다
Anthropic 공식 안내는 세 에이전트를 명시한다. ClaudeBot은 모델 개발에 활용될 수 있는 웹 콘텐츠를 수집하고, Claude-SearchBot은 검색 결과의 관련성과 정확도를 높이기 위해 웹을 탐색하며, Claude-User는 사용자의 질문에 따라 페이지를 가져온다. 세 이름을 모두 ClaudeBot으로 뭉뚱그리면 학습 제한과 검색 노출 설정을 분리할 수 없다. Anthropic은 세 봇이 모두 robots.txt 산업 표준 지시문을 준수하고, CAPTCHA 같은 접근 차단 기술을 우회하지 않으며, 비표준 확장인 Crawl-delay도 지원한다고 공식 문서에 명시했다. 크롤링 부하가 걱정되면 전면 차단 대신 속도만 제한하는 편이 낫다.
User-agent: ClaudeBot
Crawl-delay: 1
또 하나 자주 빠지는 함정이 있다. Anthropic은 “봇 운영 IP를 방화벽으로 차단하면 봇이 robots.txt를 읽지 못해 옵트아웃이 제대로 반영되지 않을 수 있다”고 공식 안내한다. 학습 제한 의사가 있는 사이트라면 IP 차단보다 robots.txt 규칙을 먼저 반영하고, IP 필터는 위조 트래픽을 걸러내는 용도로만 쓰는 것이 안전하다.
Perplexity 공식 문서에서 PerplexityBot은 검색 결과에 사이트를 노출하고 링크하기 위한 에이전트이며 기반 모델 학습용이 아니다. Perplexity-User는 사용자의 질문에 응답하기 위해 페이지를 방문한다. 사용자 요청형 에이전트는 일반 자동 크롤링과 robots.txt 적용 방식이 다를 수 있으므로 WAF에서 무조건 차단하기 전에 공식 IP 범위와 서버 로그를 함께 확인해야 한다. Perplexity는 특히 Perplexity-User가 “사용자가 요청한 가져오기이므로 일반적으로 robots.txt 규칙을 무시한다”고 명시하고, Cloudflare·AWS WAF에서 user-agent와 공식 IP를 함께 허용하는 규칙 예시를 제공한다.
robots.txt로 할 수 있는 것과 할 수 없는 것
Google robots.txt 사양 문서는 robots.txt 파일을 사이트 최상위 경로에 둬야 한다고 설명한다. 예를 들어 https://example.com/robots.txt처럼 배치해야 한다. 이 파일은 User-agent, Allow, Disallow, Sitemap 같은 지시문으로 크롤러 접근 규칙을 제공한다.
하지만 robots.txt는 강제 보안 장치가 아니다. 선의의 크롤러가 참고하는 공개 규칙에 가깝다. 민감한 파일을 숨기는 용도로 쓰면 안 된다. 차단된 URL도 외부 링크나 다른 신호를 통해 알려질 수 있고, 악성 봇은 robots.txt를 무시할 수 있다.
AI 검색 노출을 원할 때의 허용 전략
AI 검색에서 인용되고 싶다면 검색·답변 노출과 관련된 봇을 무조건 차단하지 않는 편이 좋다. 예를 들어 OAI-SearchBot·Claude-SearchBot·PerplexityBot은 검색 노출을 위해 열어두고, 학습 목적의 GPTBot·ClaudeBot은 별도로 판단할 수 있다. Google 검색 노출을 유지하려면 Googlebot도 계속 허용해야 한다.
User-agent: Googlebot
Allow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

Sitemap: https://example.com/sitemap.xml
위 예시는 Google·ChatGPT·Claude·Perplexity 검색 노출은 유지하되 OpenAI·Anthropic의 모델 학습용 크롤링은 제한하려는 출발점이다. 사용자 요청형 ChatGPT-User·Claude-User·Perplexity-User는 자동 크롤러와 구분해 결정해야 한다. 실제 적용 전에는 공식 문서의 최신 user-agent 이름, 공개 IP 범위, 서버 로그를 확인해야 한다.
AI 학습·수집을 제한하고 싶을 때의 차단 전략
콘텐츠 라이선스가 엄격하거나 유료 콘텐츠가 많거나, AI 학습 이용을 원치 않는다면 AI 크롤러를 더 넓게 차단할 수 있다. Cloudflare 문서는 AI bots 차단 기능에서 GPTBot, ClaudeBot, GoogleOther, CCBot 등 여러 AI 크롤러를 다룬다고 설명한다. Cloudflare 같은 보안 계층을 쓰면 robots.txt보다 더 적극적인 차단 규칙을 만들 수 있다. 특히 Cloudflare는 2026-09-15부터 신규 도메인에 새 기본값을 적용한다. Training으로 분류된 봇과 Agent로 분류된 봇은 광고가 표시되는 페이지에서 차단되고 Search는 허용된다. 검색+학습 겸용 봇도 “AI 학습 차단” 계열 설정에서는 함께 차단된다. 기존 “Block AI bots” 스위치는 이 날짜부터 지원 중단되므로 Cloudflare 사용 사이트라면 Security Settings의 AI 봇 정책 프리셋을 다시 확인해야 한다.
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /
다만 이 방식은 AI 검색 인용 가능성을 낮출 수 있다. 또한 서비스마다 user-agent 이름과 정책이 바뀔 수 있으므로 정기적으로 점검해야 한다. OpenAI는 robots.txt 변경이 검색 시스템에 반영되는 데 약 24시간이 걸릴 수 있다고 안내하니, 규칙을 바꾼 뒤에는 최소 하루를 두고 효과를 확인한다.
llms.txt, sitemap.xml, 구조화 데이터와 같이 써야 하는 이유
robots.txt는 접근 허용·차단의 신호다. 반면 llms.txt는 AI 에이전트에게 사이트의 중요한 문서와 사용 맥락을 안내하는 파일에 가깝다. sitemap.xml은 검색엔진에게 URL 목록을 제공하고, 구조화 데이터는 페이지의 의미를 기계가 더 잘 이해하도록 돕는다.
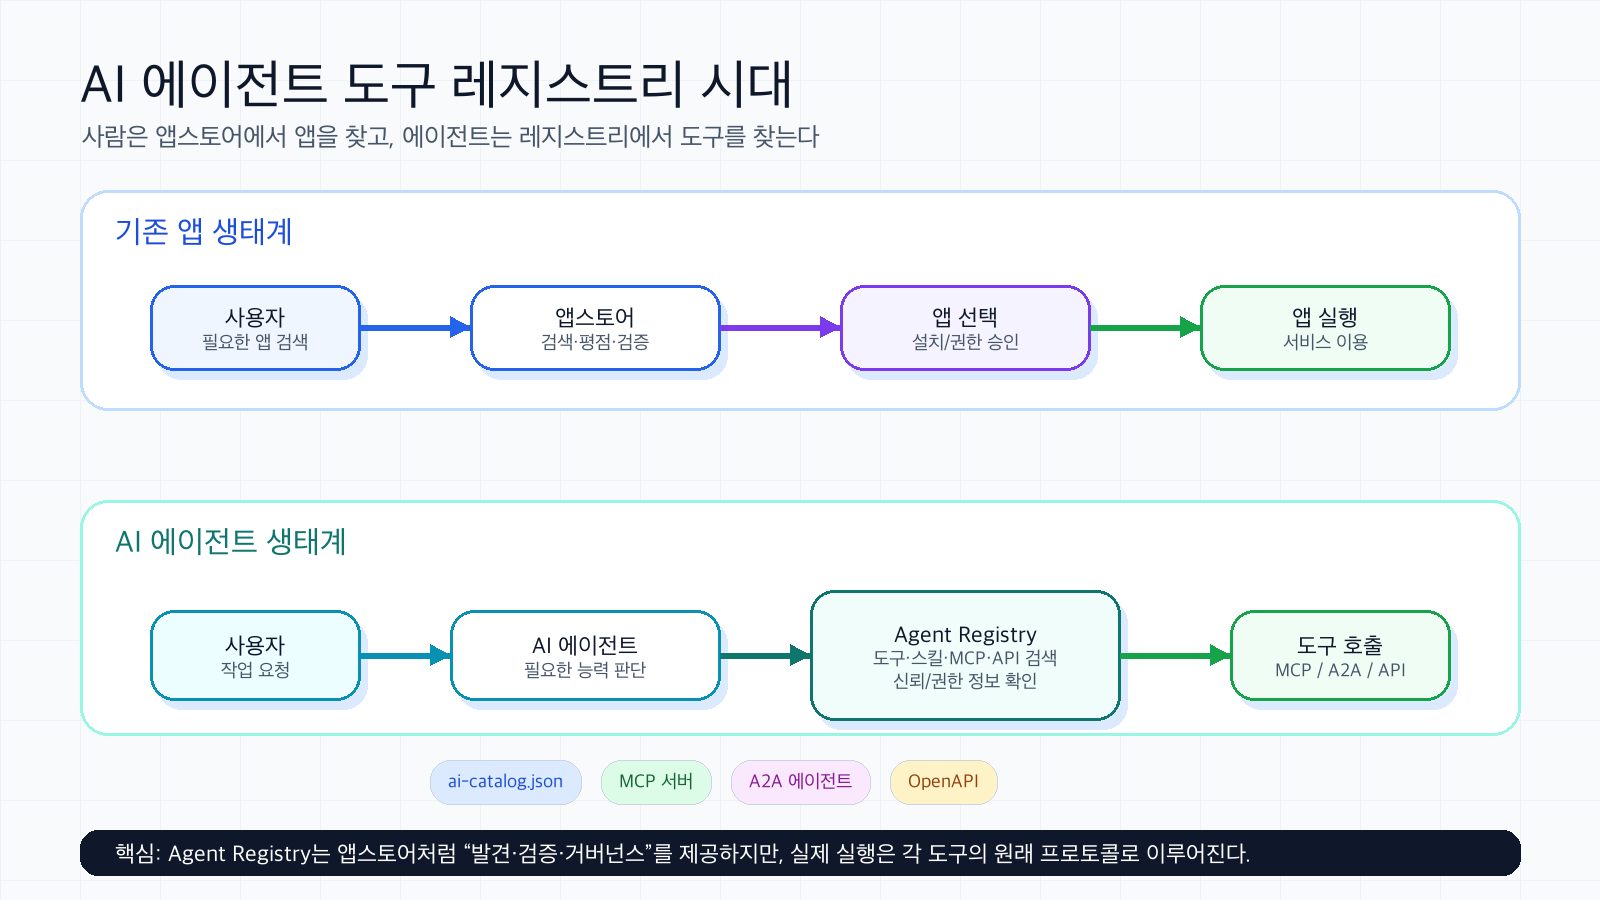
따라서 AI 검색 시대의 사이트 운영은 하나의 파일로 끝나지 않는다. llms.txt 작성 방법, AI 검색 최적화 GEO 전략, Agentic Resource Discovery, 그리고 정책 적용 뒤 실제 AI 검색 유입이 늘었는지 확인하는 AI 검색 트래픽 측정 방법까지 함께 연결해 봐야 한다.
운영자용 의사결정 체크리스트
| 질문 | 허용 쪽 신호 | 차단 쪽 신호 |
|---|---|---|
| AI 검색에 인용되고 싶은가 | 검색·답변 봇 허용 | 전체 차단은 불리 |
| 콘텐츠 라이선스가 엄격한가 | 일부 공개 페이지만 허용 | 학습 목적 봇 차단 |
| 서버 부하가 큰가 | crawl-delay 또는 보안 계층 검토 | 과도한 봇 차단 |
| 유료 콘텐츠가 있는가 | 무료 샘플만 노출 | 유료 경로 차단 |
| GEO가 중요한가 | OAI-SearchBot·Claude-SearchBot·PerplexityBot·Googlebot 허용 검토 | 학습 봇만 별도 차단 |
자주 묻는 질문
GPTBot을 차단하면 ChatGPT에 내 글이 절대 나오지 않나?
그렇게 단순하지 않다. GPTBot은 학습 목적 크롤러로 설명된다. 검색·사용자 요청 기반 방문과는 다른 경로가 있을 수 있으므로 OAI-SearchBot, ChatGPT-User 같은 이름을 분리해 봐야 한다.
robots.txt만 쓰면 AI 학습을 완전히 막을 수 있나?
아니다. robots.txt는 선의의 크롤러에게 제공하는 공개 규칙이다. 강제 보안 장치가 아니므로 서버 로그, WAF, Cloudflare 같은 보안 계층, 법적·라이선스 정책을 함께 봐야 한다.
AI 검색 노출을 원하면 무엇을 허용해야 하나?
일반 검색 노출을 위해 Googlebot은 보통 허용한다. AI 검색과 연결되는 봇은 각 서비스의 공식 문서에서 user-agent 이름과 목적을 확인한 뒤 허용 여부를 정해야 한다. OpenAI는 OAI-SearchBot과 GPTBot, Anthropic은 Claude-SearchBot과 ClaudeBot을 분리해 판단할 수 있다. Perplexity 검색 노출에는 PerplexityBot 허용 여부를 확인해야 한다.
ClaudeBot이 너무 자주 들어와서 부하가 걸린다. 차단 말고 방법이 있나?
있다. Anthropic은 robots.txt의 비표준 확장인 Crawl-delay를 지원한다. User-agent: ClaudeBot 아래에 Crawl-delay: 1처럼 초 단위 지연을 적으면 전면 차단 없이 크롤 속도를 줄일 수 있다. 학습 제한 의도가 아니라면 Disallow보다 Crawl-delay가 먼저다.
robots.txt 대신 IP로 차단하면 더 확실한가?
그렇지 않다. Anthropic은 IP 차단이 봇의 robots.txt 접근까지 막아버려 옵트아웃이 반영되지 않을 수 있다고 경고한다. IP 규칙은 공식 IP 범위 JSON과 교차검증해 위조 user-agent를 걸러내는 용도로 쓰고, 허용·차단 선언 자체는 robots.txt에 두는 것이 원칙이다.
공식 참고 문서
- OpenAI: Overview of OpenAI Crawlers
- Anthropic: 웹 크롤러 세 종류와 차단 방법
- Perplexity: 공식 크롤러 안내
- Cloudflare: Verified bots
- Google 검색 센트럴: robots.txt 소개
- Cloudflare: Block AI Bots(2026-09-15 기본값 변경)